gpt-oss in locale: come usarlo con Ollama, LM Studio e Bionic

gpt-oss è la famiglia di modelli a pesi aperti di OpenAI. È pensata per il ragionamento, per i compiti da agente e per il lavoro degli sviluppatori. Ci sono due taglie, 20b e 120b, e si possono usare sul proprio computer, senza servizi cloud. Questa guida è per chi vuole provare gpt-oss in locale e deve ancora scegliere il programma. Spiega come scaricare il modello, avviarlo e usarlo con tre strumenti: Ollama, LM Studio e LM Studio Bionic. Alla fine gpt-oss-20b sarà in funzione sul vostro computer e saprete che cosa chiede la taglia grande. I comandi sono quelli della documentazione ufficiale, elencata in fondo.
Cosa serve
I dati vengono dalla pagina di gpt-oss nella libreria di Ollama e dalla scheda ufficiale del modello su Hugging Face, pubblicata da OpenAI.
- gpt-oss-20b: grazie alla quantizzazione MXFP4 può funzionare su sistemi con 16 GB di memoria. Il fabbisogno effettivo dipende anche dalla configurazione e dalla lunghezza del contesto usata. Il modello occupa 14 GB.
- gpt-oss-120b: può stare in una singola GPU da 80 GB. La scheda ufficiale fa l’esempio della NVIDIA H100. È una configurazione sufficiente, non l’unica possibile. Se però una parte del modello viene eseguita sulla CPU, le prestazioni calano. Il modello occupa 65 GB.
- Uno dei tre programmi, già installato. Per l’installazione abbiamo una guida per ciascuno: Ollama su Linux, LM Studio e LM Studio Bionic.
Le due taglie hanno la stessa finestra di contesto massima, 128K token. La licenza è Apache 2.0: permette l’uso commerciale e le modifiche, senza vincoli copyleft. Secondo la scheda di OpenAI, la 20b ha 21 miliardi di parametri, di cui 3,6 miliardi attivi. La 120b ne ha 117 miliardi, di cui 5,1 miliardi attivi.
Scegliere il programma e la taglia
OpenAI ha quantizzato nel formato MXFP4 i pesi della parte mixture-of-experts, che vale oltre il 90% dei parametri, per ridurre la memoria necessaria. Su un computer comune la scelta pratica è gpt-oss-20b, che in Ollama corrisponde anche al tag latest. Nella libreria di Ollama ci sono anche i tag gpt-oss:20b-cloud e gpt-oss:120b-cloud. Sono versioni cloud: non hanno una dimensione da scaricare e non servono per l’uso in locale.
La tabella riassume cosa offre ciascun programma per gpt-oss, secondo le pagine ufficiali.
| Programma | Come si usa | gpt-oss nelle pagine ufficiali |
|---|---|---|
| Ollama | Terminale (esiste anche un’app) | Tag 20b e 120b, con i comandi per scaricarli e avviarli |
| LM Studio | App con lo strumento a riga di comando lms |
Comando di download solo per la 20b, nella scheda di OpenAI |
| LM Studio Bionic | Interfaccia grafica | Procedura generale per cercare e scaricare modelli locali; gpt-oss non è nominato |
Scaricare gpt-oss-20b con Ollama
Se scaricate il modello prima di avviarlo, al primo avvio non dovrete aspettare il download. La scheda di OpenAI indica questo comando per chi usa hardware consumer:
ollama pull gpt-oss:20bQuando il download è finito, il modello resta sul disco e Ollama lo usa a ogni avvio senza riscaricarlo.
Avviare e provare il modello con Ollama
Questo comando apre una chat nel terminale. Secondo la pagina della libreria di Ollama, se il modello non c’è ancora lo scarica.
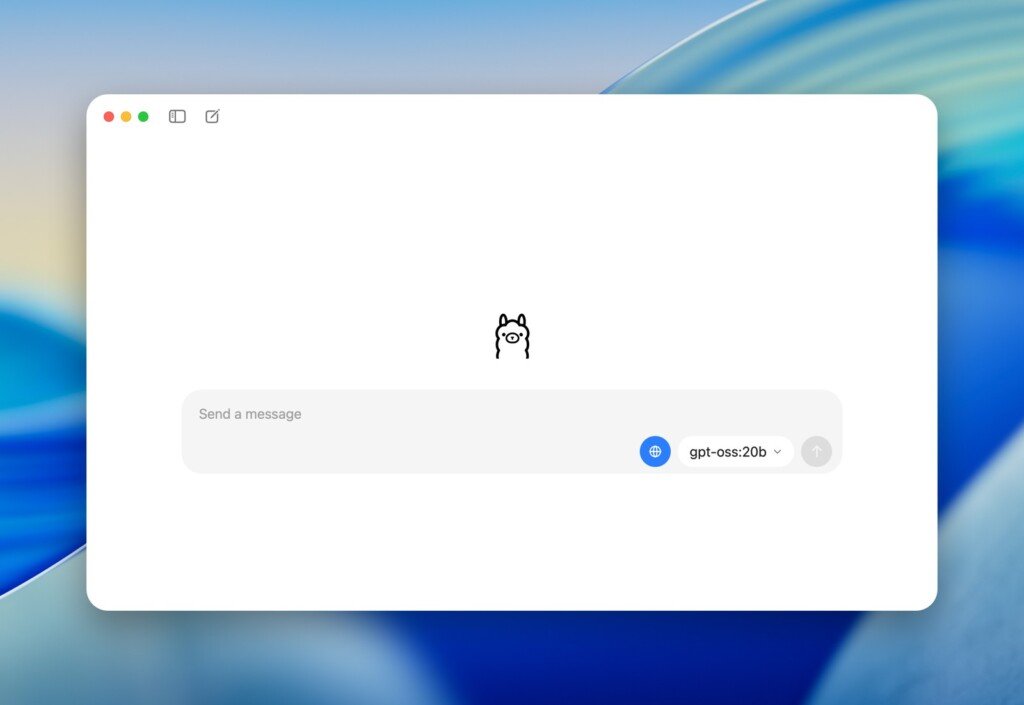
ollama run gpt-oss:20bQuando compare il prompt, scrivete una domanda e premete Invio. gpt-oss mostra per intero il suo ragionamento, utile per il debug. La scheda di OpenAI precisa però che non è pensato per essere mostrato agli utenti finali. La scheda di OpenAI indica tre livelli di sforzo di ragionamento, low, medium e high. In Ollama però il livello non si cambia scrivendolo nel prompt di sistema: secondo la pagina sul ragionamento della documentazione di Ollama, per gpt-oss si sceglie con l’impostazione think, che accetta proprio low, medium e high, e se non la indicate resta medium.
Se avete l’hardware per la taglia grande, per esempio una GPU da 80 GB, potete usare la 120b. Pesa 65 GB: prima di lanciare il comando controllate lo spazio libero sul disco.
ollama run gpt-oss:120bControllare il modello caricato e il contesto in Ollama
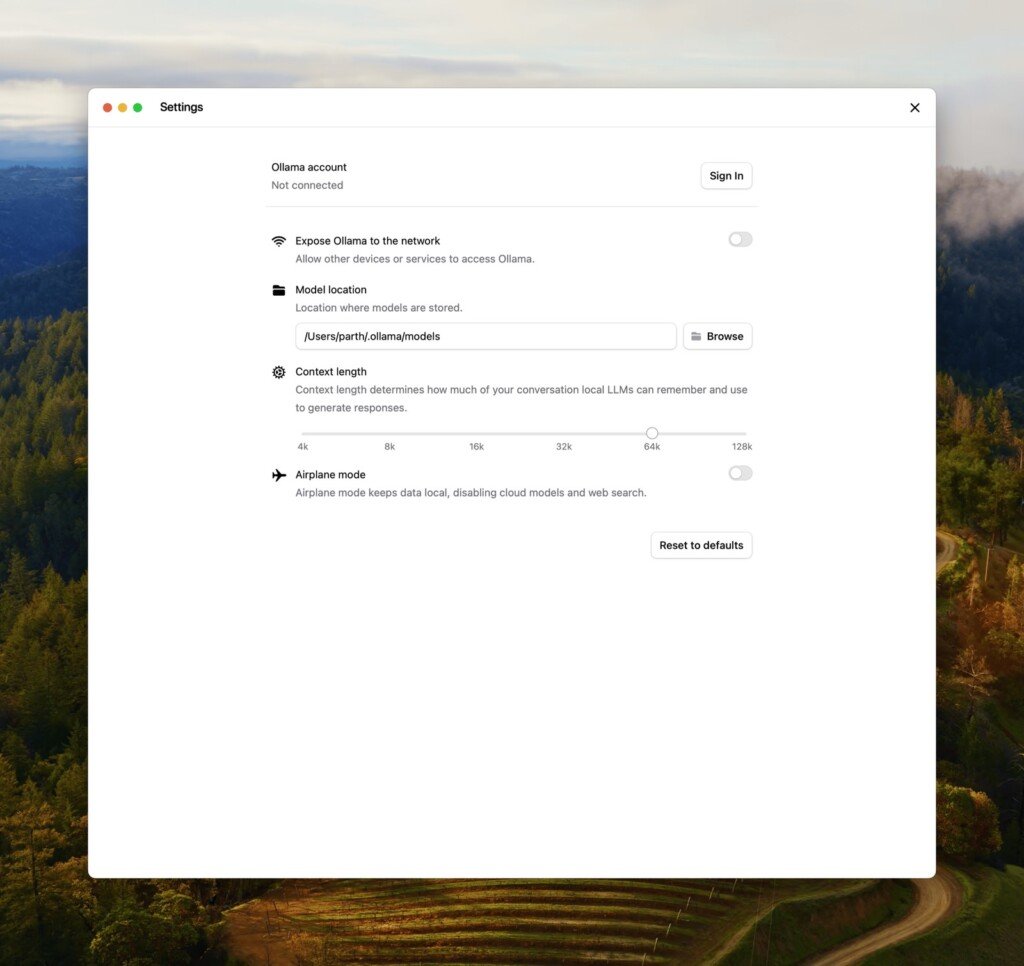
Il contesto è il numero massimo di token a cui il modello ha accesso in memoria. In Ollama la lunghezza predefinita non è fissa: secondo la documentazione di Ollama sul contesto dipende dalla VRAM disponibile.
- meno di 24 GiB di VRAM: 4k token;
- da 24 a meno di 48 GiB: 32k token;
- 48 GiB o più: 256k token.
In ogni caso gpt-oss arriva al massimo a 128K token. Per la ricerca web, gli agenti e gli strumenti di programmazione Ollama consiglia almeno 64000 token. Un contesto più lungo, però, aumenta la memoria necessaria. Nell’app di Ollama la lunghezza si regola con un cursore nelle impostazioni.
Con il modello in esecuzione, aprite un secondo terminale e controllate cosa è caricato:
ollama psL’elenco mostra nome, dimensione e le colonne PROCESSOR e CONTEXT. PROCESSOR indica come il modello è diviso fra GPU e CPU. Per le prestazioni migliori Ollama consiglia di non spostarne una parte sulla CPU. CONTEXT indica quanti token sono stati assegnati.
Togliere gpt-oss da Ollama
Se il modello non vi serve più, rimuoverlo libera spazio: 14 GB per la 20b, 65 GB per la 120b. Si usa il comando ollama rm seguito dal nome del modello, così come compare nell’elenco dei modelli installati. La rimozione cancella il modello dal disco: per usarlo di nuovo bisogna riscaricarlo.
Preparare LM Studio e scaricare gpt-oss-20b con lms
In LM Studio il download passa da lms, lo strumento a riga di comando incluso nel programma. Prima di usarlo bisogna avviare LM Studio almeno una volta: la documentazione di lms lo indica come prerequisito. Fatto questo, aprite un terminale e controllate che lo strumento risponda:
lms --helpSe funziona, compare l’elenco dei comandi, fra cui chat, get, ls e ps. Ora scaricate il modello con il comando indicato nella scheda di OpenAI su Hugging Face:
lms get openai/gpt-oss-20bPer LM Studio le pagine ufficiali consultate danno il comando di download solo per la 20b.
Chattare con gpt-oss in LM Studio
Prima di aprire la chat, controllate che il download sia finito. Questo comando elenca i modelli sul disco e mostra il nome da scegliere:
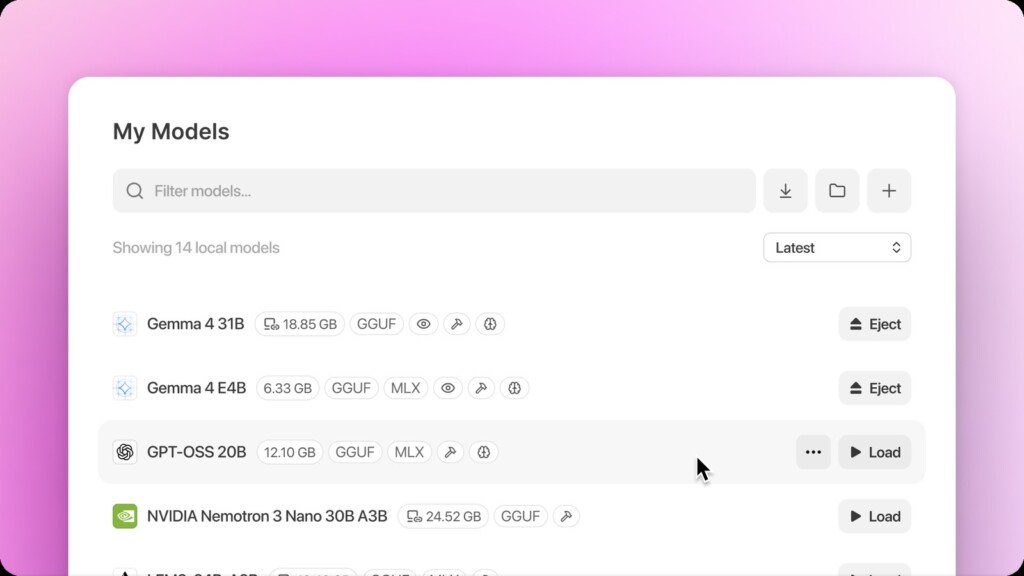
lms lsL’elenco corrisponde alla cartella dei modelli impostata nella scheda My Models dell’app. Con lms chat parlate con un modello locale direttamente dal terminale. Se non indicate il modello, il programma vi chiede quale usare: scegliete gpt-oss-20b.
lms chatLa documentazione di lms chat descrive anche l’opzione per il prompt di sistema, dove potete indicare il livello di ragionamento, per esempio Reasoning: high. Dopo la fine della chat il modello resta caricato per 3600 secondi, il valore predefinito.
Per vedere quali modelli sono caricati in memoria:
lms psUsare gpt-oss in LM Studio Bionic
In Bionic si fa tutto dall’interfaccia grafica. La documentazione di Bionic sui modelli locali descrive la procedura generale e non nomina gpt-oss. I passaggi:
- Aprite Settings e, sotto Local Models, selezionate Explore.
- Cercate gpt-oss. Potete restringere i risultati con i filtri per formato e con le informazioni sulla compatibilità con il dispositivo.
- Se con LM Link avete più dispositivi, scegliete dove scaricare il modello.
- Scegliete formato e variante e avviate il download. Potete metterlo in pausa, riprenderlo, annullarlo o riprovarlo.
- Aprite Settings → Local Models → Library e controllate che il modello compaia fra quelli del dispositivo.
- Aprite una sessione di Bionic e scegliete il modello dall’elenco.
I modelli scaricati girano sul vostro computer e non consumano crediti di inferenza cloud. Se gpt-oss non compare fra i risultati di Explore, la documentazione non dice come procedere: in quel caso usate Ollama o LM Studio con i comandi delle sezioni precedenti.
Documentazione di riferimento
Pagine ufficiali consultate il 1 ottobre 2026:
- Libreria di Ollama: gpt-oss
- Hugging Face, organizzazione OpenAI: scheda di gpt-oss-20b
- Documentazione di Ollama: lunghezza del contesto
- Documentazione di LM Studio: lms, la CLI
- Documentazione di LM Studio: lms chat
- Documentazione di LM Studio Bionic: scaricare e usare modelli locali