Ollama su Linux: come installarlo e usare un modello in locale

Con Ollama scarichi un modello linguistico e lo usi sul tuo computer Linux, senza passare da un servizio cloud. Questa guida parte da zero. Prima installi Ollama con lo script ufficiale e controlli che il servizio systemd sia attivo. Poi scarichi il modello gemma4 e lo usi in due modi: in chat dal terminale e con una richiesta all’API REST locale sulla porta 11434. Nelle ultime sezioni vedi come gestire i modelli e come disinstallare tutto. I comandi sono quelli della documentazione ufficiale di Ollama, che trovi elencata in fondo.
Cosa serve
La pagina Linux della documentazione di Ollama non fa differenze tra le distribuzioni. Gli altri requisiti si ricavano dai controlli dello script di installazione ufficiale:
- un sistema Linux con architettura x86_64 (amd64) oppure aarch64/arm64. Su qualsiasi altra architettura lo script si ferma con l’errore
Unsupported architecture; - un utente che può usare
sudo, oppure l’utente root, perché lo script ha bisogno dei permessi da superutente; - i programmi
curl,awk,grep,sed,teeexargs, che lo script cerca prima di partire, piùzstdper estrarre l’archivio; - systemd in funzione, se vuoi che Ollama giri come servizio. Se il comando
systemctlesiste ma systemd non è in esecuzione, lo script crea l’utente e il file del servizio, ma non abilita e non avvia il servizio; - una GPU NVIDIA o AMD, se vuoi usarla. Non è obbligatoria: lo script la cerca con
lspciolshwe, se non ne trova, Ollama lavora solo con la CPU; - spazio su disco e memoria sufficienti per il modello. Senza tag, i comandi di questa guida scaricano
gemma4:latest, che oggi corrisponde alla variante E4B. Per la versione llama.cpp usata su Linux, il registro dei modelli di Ollama indica circa 6,6 GB, mentregemma4:e2bpesa circa 4,6 GB. La dimensione del download non coincide con la memoria che serve mentre il modello lavora. La Quickstart consiglia 8 GB di VRAM libera, ma il dato riguarda la variante E2B. Con meno VRAM Ollama può usare anche la RAM di sistema, ma le risposte potrebbero essere più lente. Finestre di contesto più ampie richiedono più memoria; - se usi WSL su Windows, ti serve WSL2: WSL1 non è supportato.
Installare zstd prima dello script
Ollama viene distribuito come archivio .tar.zst. Se zstd manca, lo script si ferma prima di estrarre i file. Installalo quindi prima, con il comando adatto alla tua distribuzione: sono gli stessi tre comandi che lo script suggerisce nel suo messaggio di errore.
Su Debian e Ubuntu:
sudo apt-get install zstdSu Fedora (lo script indica lo stesso comando anche per RHEL e CentOS):
sudo dnf install zstdSu Arch Linux:
sudo pacman -S zstdPer le altre distribuzioni la documentazione non riporta un comando: usa il gestore pacchetti del tuo sistema. Puoi andare avanti quando il gestore installa il pacchetto senza errori o ti dice che è già presente.
Installare Ollama con lo script ufficiale
Secondo la documentazione Linux di Ollama, per installare basta un solo comando. Lo stesso comando serve anche per aggiornare Ollama in futuro.
Attenzione: questo comando scarica codice da internet e lo esegue subito, senza chiedere conferma. Lo script usa
sudo, quindi lavora con i privilegi di amministratore. Installa Ollama, crea l’utente e il gruppoollama, aggiunge il tuo utente al gruppoollamae configura il servizio systemdollama. Se trova una GPU NVIDIA, può anche aggiungere i repository NVIDIA e installare i driver CUDA. Su Debian, in quel caso, abilita anche le sorgenticontrib. Se lo rilanci, riscrive il file/etc/systemd/system/ollama.service. Per questo le personalizzazioni vanno fatte consudo systemctl edit ollama, come indica la documentazione, e non dentro quel file. Se vuoi leggere lo script prima di lanciarlo, lo trovi all’indirizzohttps://ollama.com/install.she nel repository GitHub di Ollama.
curl -fsSL https://ollama.com/install.sh | shMentre lavora, lo script stampa una riga per ogni passaggio: il download, la creazione dell’utente ollama, la creazione del servizio systemd. Alla fine scrive che l’API è disponibile su 127.0.0.1:11434 e che l’installazione è completa. Se non hai una GPU NVIDIA o AMD, compare anche un avviso: Ollama userà solo la CPU.
Avviare e verificare il servizio Ollama
Se systemd è attivo, lo script abilita e avvia da solo il servizio ollama. Se il servizio non è partito, oppure lo hai fermato tu, avvialo con:
sudo systemctl start ollamaPoi controlla il suo stato:
sudo systemctl status ollamaLo stato deve indicare che il servizio è attivo. Per sapere quale versione hai installato:
ollama -vSe compare un numero di versione, l’eseguibile si trova nel PATH e risponde. Se il servizio non parte o si ferma subito, leggi i suoi log:
journalctl -e -u ollamaScaricare il modello gemma4
Ora scarica un modello dal registro di Ollama. Gli esempi della CLI Reference usano gemma4:
ollama pull gemma4I nomi dei modelli seguono il formato modello:tag. La documentazione delle API spiega che, se il tag non c’è, come in questo caso, Ollama usa latest. Finito il download, controlla quali modelli hai sul disco:
ollama lsNell’elenco deve esserci gemma4.
Chattare con il modello dal terminale
Per parlare con il modello in modo interattivo:
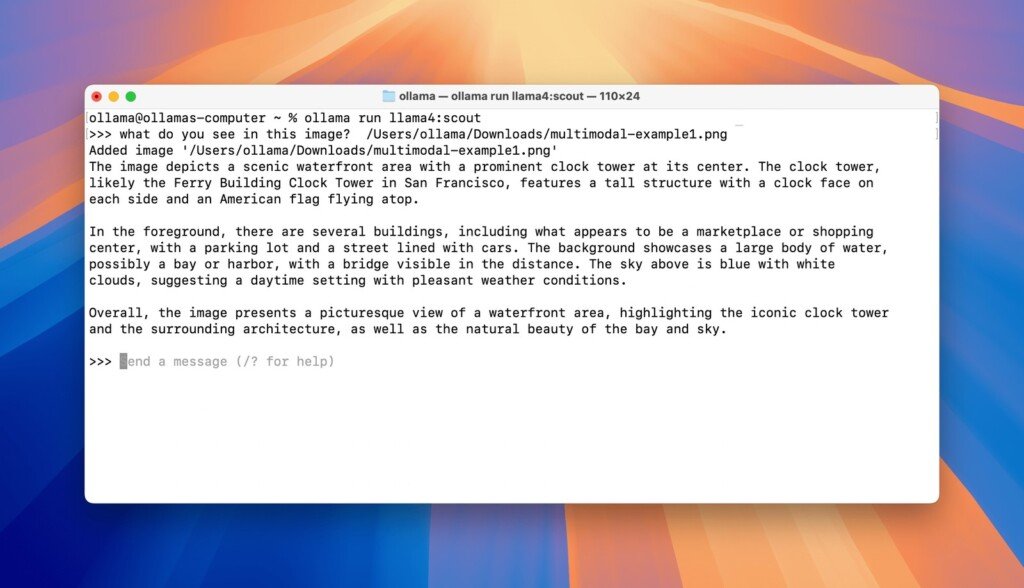
ollama run gemma4Scrivi le tue domande al prompt >>>. Se un testo occupa più righe, mettilo tra tre virgolette doppie (""") all’inizio e alla fine, come spiega la CLI Reference. Per chiudere la sessione scrivi /bye, come indica la Quickstart.
Interrogare il modello via API REST
Il servizio è in ascolto su localhost, porta 11434, e risponde alle richieste HTTP. Così puoi usare il modello da uno script o da altre applicazioni. Questa richiesta all’endpoint /api/chat viene dal README del repository ufficiale:
curl http://localhost:11434/api/chat -d '{
  "model": "gemma4",
  "messages": [{
    "role": "user",
    "content": "Why is the sky blue?"
  }],
  "stream": false
}'
Con "stream": false ricevi tutta la risposta in un solo oggetto JSON. Senza questa opzione l’endpoint manda una serie di oggetti, ognuno con un pezzo del testo. Il testo generato si trova nel campo message.content. Il campo done vale true e accanto ci sono alcune statistiche, come eval_count, cioè il numero di token della risposta. Le durate sono in nanosecondi.
Per avere dall’API l’elenco dei modelli presenti sul computer:
curl http://localhost:11434/api/tagsÈ l’equivalente HTTP di ollama ls: tra i modelli restituiti deve esserci gemma4.
Vedere, fermare e rimuovere i modelli
Un modello non lascia la memoria appena ha risposto. Con l’API, per impostazione predefinita, resta caricato per 5 minuti dopo l’ultima richiesta. Per vedere quali modelli sono caricati in questo momento:
ollama psPer togliere subito gemma4 dalla memoria:
ollama stop gemma4Se il modello non ti serve più e vuoi liberare spazio, cancellalo dal disco. Per usarlo di nuovo dovrai riscaricarlo con ollama pull:
ollama rm gemma4Disinstallare Ollama
La documentazione Linux spiega come togliere tutto a mano, in quest’ordine: il servizio, i file del programma, l’utente di sistema e i dati. Per prima cosa ferma il servizio e toglilo dall’avvio automatico:
sudo systemctl stop ollamasudo systemctl disable ollamaPoi cancella il file del servizio creato dallo script:
sudo rm /etc/systemd/system/ollama.serviceRimuovere le librerie
Le librerie stanno in una cartella ollama dentro la directory lib, accanto alla directory bin che contiene l’eseguibile. Di solito il percorso è /usr/local/lib/ollama. Vanno tolte prima dell’eseguibile, perché il loro percorso si ricava proprio dalla posizione dell’eseguibile.
Comincia controllando dove si trova l’eseguibile. Scrivi which ollama: deve rispondere /usr/local/bin/ollama, /usr/bin/ollama oppure /bin/ollama. Se non compare niente, o compare un percorso diverso da questi tre, fermati: i comandi di rimozione che seguono cancellerebbero il percorso sbagliato. Poi scrivi which ollama | tr 'bin' 'lib' per vedere, senza cancellare nulla, quale cartella verrà eliminata. Deve risultare /usr/local/lib/ollama, /usr/lib/ollama oppure /lib/ollama.
Attenzione: il comando che segue cancella per sempre quella cartella e tutto quello che contiene. Usalo solo se il percorso che hai appena visto è uno dei tre indicati sopra. Se cancelli la cartella sbagliata, perdi file che non c’entrano niente con Ollama.
Il comando che la documentazione Linux indica per rimuovere le librerie è sudo rm -r $(which ollama | tr 'bin' 'lib'). Copialo dalla sezione Uninstall della pagina ufficiale. La parte tra $( ) è il percorso che hai controllato prima, e rm -r cancella quella cartella.
Rimuovere l’eseguibile, l’utente e i dati
Attenzione: anche questo comando cancella un file in modo definitivo. La shell sostituisce da sola
$(which ollama)con il percorso dell’eseguibile, lo stesso che hai controllato conwhich ollama. Se quel controllo non ti ha dato uno dei tre percorsi indicati sopra, non lanciare il comando.
sudo rm $(which ollama)Poi elimina l’utente e il gruppo di sistema creati dallo script:
sudo userdel ollamasudo groupdel ollamaAttenzione: il prossimo comando cancella la cartella
/usr/share/ollamacon tutto il suo contenuto. È la cartella home dell’utenteollamae, secondo la documentazione, contiene anche i modelli scaricati: se la cancelli e poi li rivuoi, devi scaricarli di nuovo. Prima di premere Invio controlla di aver scritto esattamente questo percorso.
sudo rm -r /usr/share/ollamaSe qualcosa va storto
Ecco i problemi che lo script di installazione prevede, ognuno con il suo messaggio:
- Manca zstd. Lo script si ferma con un errore che comincia con This version requires zstd for extraction. Installa zstd come spiegato sopra e rilancia lo script.
- Mancano altri programmi. Con il messaggio The following tools are required but missing, lo script elenca quali programmi non trova tra curl, awk, grep, sed, tee e xargs. Installali e riprova.
- Manca sudo. Se non sei root e
sudonon è installato, lo script ti chiede di rilanciarlo come root. - Stai usando WSL1. Non è supportato: lo script ti chiede di passare a WSL2.
- systemd non è attivo. Lo script mostra l’avviso systemd is not running: crea l’utente e il file del servizio, ma non abilita e non avvia il servizio. In questo caso la Quickstart indica di avviare il server a mano con
ollama serve. Lanciato così, il server occupa il terminale da cui l’hai avviato. Perollama pull,ollama rune gli altri comandi apri quindi un secondo terminale, come fa la documentazione Linux per l’installazione manuale. Su WSL2 lo script rimanda anche alla pagina Microsoft che spiega come attivare systemd. - La GPU non viene riconosciuta. Se mancano sia
lspcisialshw, lo script non può cercare la scheda NVIDIA o AMD. Installa uno dei due programmi e rilancia lo script. - Serve un riavvio per i driver NVIDIA. Se è caricato il driver nouveau, lo script termina con Reboot to complete NVIDIA CUDA driver install. Riavvia il computer per completare l’installazione dei driver CUDA.
Per gli altri problemi del servizio, controlla prima di tutto i log con journalctl -e -u ollama.
Documentazione di riferimento
Pagine ufficiali consultate il 1° ottobre 2026:
- Documentazione di Ollama — Linux
- Script di installazione ufficiale di Ollama (repository GitHub)
- Documentazione di Ollama — CLI Reference
- README del repository ufficiale di Ollama
- Documentazione di Ollama — Quickstart
- Documentazione API di Ollama (repository GitHub)