vLLM sulle GPU Intel: llm-scaler 1.5 porta Qwen e Gemma 4
Il container Docker per vLLM su GPU Intel passa a vLLM 0.26 e PyTorch 2.12 e aggiunge Qwen, Gemma 4, FP8 e INT4.
Il container Docker per vLLM su GPU Intel passa a vLLM 0.26 e PyTorch 2.12 e aggiunge Qwen, Gemma 4, FP8 e INT4.
Dal 13 ottobre Gemini 4 Argon è in Antigravity per gli abbonati Google AI Pro (21,99 € al mese in Italia) e…
Secondo TechPowerUp, che cita Moore's Law Is Dead, il die di Nova Lake-HX ha 8 P-core, 16 E-core e 4 LPE-core; Nova…
Secondo la pagina ufficiale dei pacchetti Gentoo, www-client/chromium è mascherato e sarà rimosso il 24 ottobre 2026.
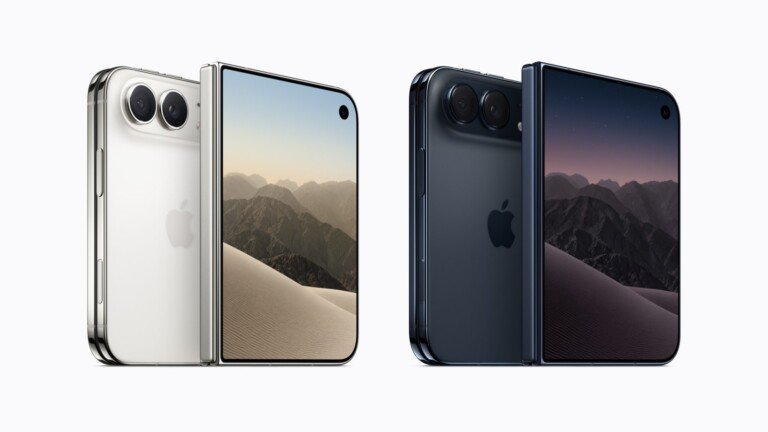
Apple descrive iPhone Duo: display interno più ampio del 50% rispetto a iPhone 18 Pro Max, chip A20 Pro, doppia batteria, IP68…
Il 15 ottobre il PostgreSQL Global Development Group ha rilasciato RC 1; seconda candidata il 12 novembre, versione finale prevista il 19.
Il CERT-AGID segnala il 16 ottobre un SMS su una multa del GRA che porta a poliziadistato[.]info, sito che non è quello…
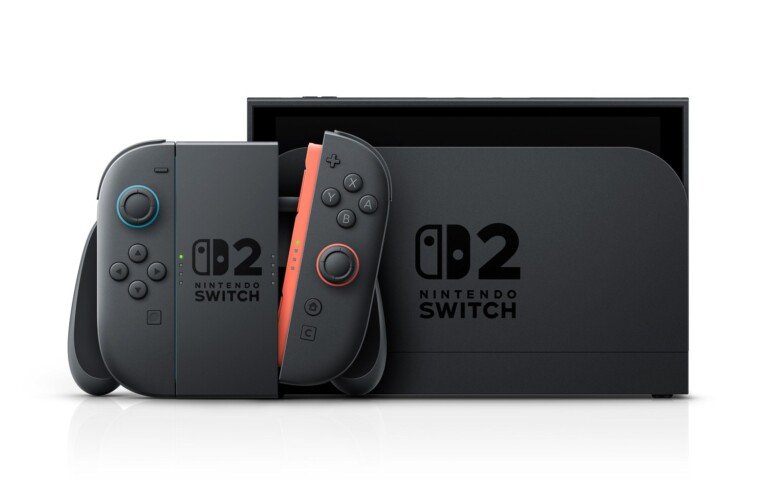
Dal 16 novembre 2026 in Giappone cambiano le tariffe di riparazione di Switch 2 e Switch; la scheda CPU di Switch 2…
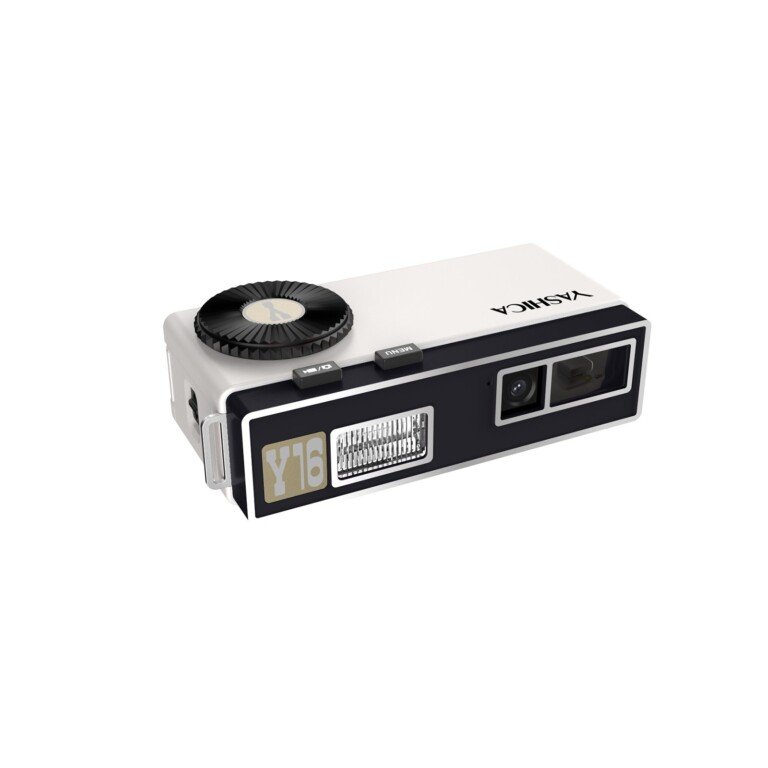
Yashica apre il preordine della Y16, compatta digitale con mirino ottico e flash allo xeno a tre livelli: HK$898, spedizioni dalla settimana…
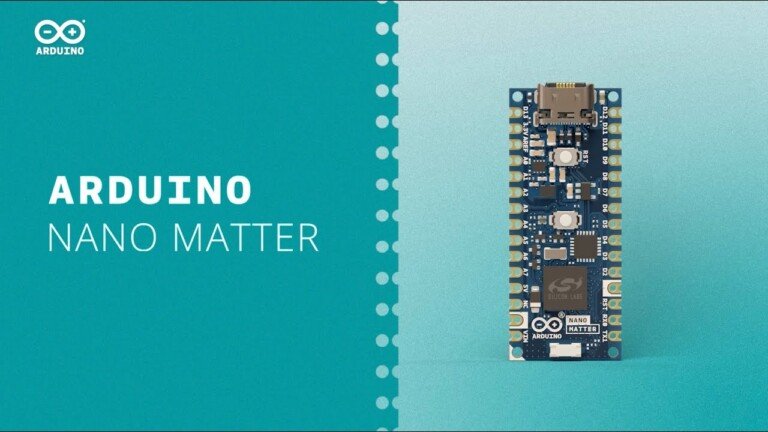
Con il core Silicon Labs 5.0 la Nano Matter compila sketch Zigbee 3.0 dall'Arduino IDE, con 14 esempi e la possibilità di…