AI in locale: che computer serve tra GPU, VRAM, RAM e mini PC

Con l’AI in locale il modello linguistico gira sul tuo computer e i prompt non passano da un servizio cloud. A decidere che cosa puoi far girare è soprattutto la memoria: quanta ne ha la scheda video, quanta ne ha il sistema e quanto pesa il modello. Questa guida è per chi vuole capire se il proprio PC basta o che cosa comprare. Spiega il ruolo di GPU, VRAM, RAM, CPU e disco, poi mostra come controllare su Linux, con Ollama, se il modello sta davvero in GPU. Alla fine passa in rassegna i computer a memoria unificata: DGX Spark, i mini PC con Ryzen AI Max e Mac Studio. Comandi e dati vengono dalla documentazione ufficiale, elencata in fondo.
Cosa serve
- Un computer Linux con systemd attivo, se vuoi seguire i passaggi sul servizio. Senza systemd puoi avviare Ollama con
ollama serve: lascia aperto quel terminale e fai le prove in un altro. La documentazione di Ollama per Linux non è scritta per una distribuzione in particolare. Lo script d’installazione supporta le architetture x86_64 e ARM64. - Il pacchetto zstd installato prima di lanciare lo script, soprattutto se stai aggiornando Ollama (più sotto spieghiamo perché).
- I permessi di amministratore (sudo) e una connessione a internet per scaricare Ollama e i modelli. Il più piccolo usato qui pesa 1,3 GB.
- Facoltativa: una GPU NVIDIA o AMD supportata. Senza GPU il modello gira sulla CPU e usa la memoria di sistema.
- Se preferisci un’interfaccia grafica c’è LM Studio. Secondo i suoi requisiti di sistema gira su macOS 14.0 o successivo con Apple Silicon, su Windows x64 o ARM e su Linux x64 o ARM64, dove richiede Ubuntu 20.04 o successivo.
Che cosa conta davvero: GPU e VRAM, RAM, CPU e disco
La GPU fa i calcoli, ma per farli il modello deve stare nella sua memoria, la VRAM. Quando carica un modello, Ollama confronta la VRAM che serve con quella libera. Se il modello entra in una sola GPU lo carica lì, e secondo le FAQ di Ollama di solito è la soluzione più veloce, perché sul bus PCI passano meno dati. Se non entra in una sola scheda lo distribuisce su tutte le GPU disponibili. Se la VRAM non basta proprio, una parte del modello finisce nella memoria di sistema.
Quando l’inferenza gira solo sulla CPU, il modello sta tutto nella RAM. LM Studio avverte che i modelli linguistici possono consumare molta RAM e ne raccomanda almeno 16 GB. Sui Mac con 8 GB potrebbe essere possibile usarlo con modelli piccoli e contesti contenuti. Su Windows raccomanda anche almeno 4 GB di VRAM dedicata.
La memoria deve contenere anche il contesto, cioè il testo che il modello tiene presente. Di default Ollama usa 4096 token. Le richieste in parallelo fanno crescere il contesto: 2K con 4 richieste parallele diventano 8K. La RAM necessaria cresce con il prodotto di OLLAMA_NUM_PARALLEL per OLLAMA_CONTEXT_LENGTH.
- CPU: su x64 LM Studio richiede il set di istruzioni AVX2. I Mac con processore Intel non sono supportati.
- Disco: su Linux Ollama salva i modelli in
/usr/share/ollama/.ollama/models, su macOS in~/.ollama/models. Con la variabileOLLAMA_MODELSpuoi spostarli in un’altra cartella. - Rete: serve per scaricare i modelli. Una volta scaricati i file, LM Studio può lavorare del tutto offline.
Quanto pesa un modello: taglia e quantizzazione
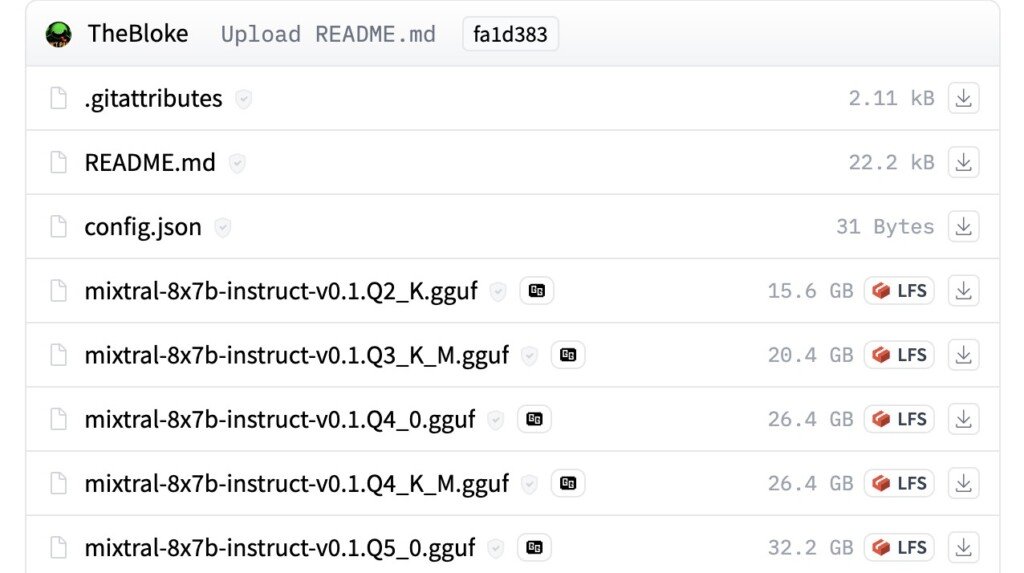
Il peso di un modello dipende da due cose. La prima è la taglia, cioè il numero di parametri (1B o 3B vuol dire uno o tre miliardi). La seconda è la quantizzazione, cioè quanti bit occupa ciascun peso. Per l’AI in locale si usa molto il formato GGUF, creato dallo sviluppatore di llama.cpp e usato anche da LM Studio e Ollama. La documentazione GGUF di Hugging Face riporta quanti bit occupa un peso con ciascun tipo di quantizzazione:
| Tipo | Bit per peso |
|---|---|
| F16 | 16 |
| Q6_K | 6,5625 |
| Q5_K | 5,5 |
| Q4_K | 4,5 |
| Q3_K | 3,4375 |
| Q2_K | 2,625 |
A parità di taglia, i pesi in Q4_K occupano poco più di un quarto di quelli in F16 (4,5 bit contro 16). Per un esempio concreto c’è la pagina di Llama 3.2 nella libreria di Ollama: la versione 1B pesa 1,3 GB e la 3B, quella predefinita, 2,0 GB. Entrambe hanno una finestra di contesto di 128K token.
Quali GPU sono supportate e come vedere le NVIDIA installate
Ecco che cosa supporta Ollama secondo la sua pagina sul supporto hardware:
- NVIDIA: compute capability 5.0 o superiore e driver 550 o successivo. Le schede da 5.0 a 6.2 richiedono il driver 570 o successivo. Nell’elenco ci sono, tra le altre, il GB10 del DGX Spark (12.1), le GeForce RTX 50xx (12.0), 40xx (8.9) e 30xx (8.6) e le GTX 10xx (6.1).
- AMD: su Linux serve il driver ROCm v7. L’elenco comprende le Radeon RX 9000, le 7000 e parte delle 6000, le Radeon PRO e i Ryzen AI Max+ 395, Max 390 e Max 385. Su Windows serve uno stack ROCm v7 / HIP7 e le schede elencate sono di meno. Altre GPU, comprese quelle Intel, possono funzionare tramite Vulkan su Windows e Linux.
- Apple: l’accelerazione passa dall’API Metal.
Se hai una scheda NVIDIA con i driver installati, questo comando elenca le GPU che il sistema vede, ciascuna con il suo UUID. L’UUID ti serve se vuoi che Ollama usi solo alcune schede: le indichi nella variabile CUDA_VISIBLE_DEVICES.
nvidia-smi -LSe nell’elenco compare la tua scheda, il driver la riconosce. Se il comando non esiste o non elenca niente, il driver NVIDIA non è installato oppure non vede la scheda.
Installare Ollama su Linux con lo script ufficiale
Lo script ufficiale riconosce l’architettura e installa Ollama. Se è disponibile systemctl, crea anche l’utente ollama e configura il servizio; lo abilita e avvia quando systemd risulta in esecuzione. Se trova una GPU AMD scarica anche il pacchetto ROCm. Se trova una NVIDIA senza driver su una distribuzione supportata, prova a installare i driver CUDA. Se alla fine ti dice che serve un riavvio per completare l’installazione dei driver NVIDIA (il messaggio è «Reboot to complete NVIDIA CUDA driver install»), salva il lavoro e riavvia prima di fare prove con la GPU.
Prima di lanciarlo, controlla con il gestore di pacchetti della tua distribuzione che zstd sia installato, soprattutto se stai aggiornando Ollama. Le versioni recenti sono distribuite come archivi .tar.zst. Lo script cancella le vecchie librerie prima di controllare se zstd c’è: se manca, l’aggiornamento si ferma quando la vecchia installazione è già stata cancellata.
Attenzione: il comando seguente scarica uno script da internet e lo esegue subito. Lo script usa sudo per modificare il sistema, installare Ollama e configurare il servizio. Durante un aggiornamento sostituisce le vecchie librerie e riscrive il file del servizio. Il sorgente è pubblico: se vuoi sapere che cosa fa, leggilo prima di lanciarlo.
curl -fsSL https://ollama.com/install.sh | shAlla fine lo script dice che l’installazione è completa e che l’API risponde su 127.0.0.1:11434. Per controllare, chiedi la versione installata:
ollama -vSe compare un numero di versione, il comando ollama è installato e lo trovi nel percorso.
Avviare il servizio e leggere i log
Questa sezione vale solo se hai systemd. Di solito lo script ha già abilitato e avviato il servizio. Se non l’ha fatto, avvialo a mano:
sudo systemctl start ollamaPoi controllane lo stato, che deve risultare attivo:
sudo systemctl status ollamaSe qualcosa non torna, per esempio un modello che dovrebbe stare in GPU e invece finisce sulla CPU, la prima cosa da guardare sono i log del servizio:
journalctl -e -u ollamaProvare un modello piccolo e poi quello predefinito
Conviene partire dal modello più leggero, Llama 3.2 1B da 1,3 GB. La prima volta Ollama lo scarica e poi apre una chat nel terminale: quello che scrivi lì arriva al modello come domanda, non alla shell.
ollama run llama3.2:1bQuando hai finito, chiudi la finestra del terminale oppure aprine una nuova. Il comando successivo va lanciato da un terminale nuovo, non dalla chat. Se il 1B funziona, prova il 3B predefinito da 2,0 GB:
ollama run llama3.2Anche i comandi delle sezioni seguenti vanno scritti in un terminale nuovo.
Controllare se il modello gira su GPU o CPU
Questo controllo ti dice se il tuo hardware lavora come speri. Il modello deve essere caricato: ottieni una risposta nella chat ed esegui ollama ps in un altro terminale entro cinque minuti dall’ultima risposta. Lasciare aperta la chat non impedisce lo scaricamento automatico dalla memoria.
ollama psQuesto è l’esempio delle FAQ di Ollama:
NAME ID SIZE PROCESSOR UNTIL
llama3:70b bcfb190ca3a7 42 GB 100% GPU 4 minutes from now
La colonna SIZE dice quanta memoria occupa il modello caricato. La colonna PROCESSOR dice dove si trova:
100% GPU: il modello è tutto nella memoria delle GPU, anche se è distribuito su più schede;100% CPU: il modello è tutto nella memoria di sistema;- una divisione come
48%/52% CPU/GPU: il modello sta in parte nella GPU e in parte nella memoria di sistema.
La colonna UNTIL dice fino a quando il modello resta in memoria: di default 5 minuti. La durata si cambia con il parametro keep_alive delle API, oppure per tutti i modelli con la variabile OLLAMA_KEEP_ALIVE. La lunghezza del contesto si imposta con OLLAMA_CONTEXT_LENGTH. Più è lungo il contesto, più memoria occupa: per questo un modello già al limite della VRAM può finire in parte sulla CPU.
Liberare subito la memoria scaricando il modello
Se ti serve la VRAM o la RAM per altro, non devi aspettare i 5 minuti: puoi togliere subito il modello dalla memoria.
ollama stop llama3.2Se rilanci ollama ps, il modello non deve più comparire tra quelli caricati.
Tornare indietro: disinstallare Ollama su Linux
Attenzione: i comandi di questa sezione fermano e disattivano il servizio. Poi cancellano il file del servizio, le librerie, l’eseguibile, l’utente e il gruppo
ollamae la cartella/usr/share/ollama. Su Linux quella cartella contiene anche i modelli scaricati (/usr/share/ollama/.ollama/models). Se non li copi altrove prima di cominciare, andranno persi. Scrivi i percorsi esattamente come sono qui: consudo rmun percorso sbagliato cancella altri file.
Per prima cosa ferma il servizio e impedisci che riparta all’avvio:
sudo systemctl stop ollamasudo systemctl disable ollamaPoi cancella il file del servizio:
sudo rm /etc/systemd/system/ollama.serviceAdesso tocca alle librerie, e vanno tolte prima dell’eseguibile. Stanno nella cartella lib che corrisponde alla cartella bin del programma: /usr/local/lib, /usr/lib o /lib. Prima controlla che which ollama restituisca il percorso dell’installazione che vuoi rimuovere. Poi esegui il comando della documentazione per Linux, che ricava la cartella delle librerie sostituendo bin con lib in quel percorso: sudo rm -r $(which ollama | tr 'bin' 'lib'). Il comando cancella le librerie di Ollama. Se cancelli prima l’eseguibile, which non trova più il percorso e le librerie restano sul disco.
Solo a quel punto elimina l’eseguibile. Qui $(which ollama) non va sostituito a mano: la shell lo rimpiazza da sola con il percorso del programma, che sta in /usr/local/bin, /usr/bin o /bin.
sudo rm $(which ollama)Per finire, elimina l’utente, il gruppo e la cartella con i modelli:
sudo userdel ollamasudo groupdel ollamasudo rm -r /usr/share/ollamaComputer pronti con memoria unificata
Su queste macchine CPU e GPU condividono la stessa memoria, quindi un modello ha a disposizione molti più gigabyte della VRAM di una scheda video comune. Le pagine ufficiali indicano la memoria totale, non quanta ne vada alla GPU.
NVIDIA DGX Spark da 64 e 128 GB
Secondo la pagina del DGX Spark, la macchina ha il superchip GB10 Grace Blackwell con CPU Arm a 20 core, 64 o 128 GB di memoria unificata LPDDR5x con una banda di 273 GB/s, fino a 4 TB di archiviazione e DGX OS. Per NVIDIA la versione da 64 GB regge modelli fino a 100 miliardi di parametri, quella da 128 GB fino a 200 miliardi. Il GB10 è nell’elenco delle GPU supportate da Ollama.
Il blog di NVIDIA del 2 ottobre 2026 annuncia la versione da 64 GB per venerdì 23 ottobre 2026, a partire da 4.999 dollari. La vendono solo i produttori partner: Acer, ASUS, Dell, Gigabyte, HP e MSI. Collegando due unità da 64 GB la memoria arriva a 128 GB. Tra i programmi supportati il blog cita llama.cpp, Ollama, vLLM e LM Studio. Il prezzo della versione da 128 GB non compare nelle pagine consultate. Ne abbiamo parlato nella notizia sul DGX Spark 64GB.
Mini PC con Ryzen AI Max: Framework Desktop
La pagina del Framework Desktop lo presenta come una workstation da 4,5 litri con 32, 64, 128 o 192 GB di LPDDR5X. La versione più alta usa il Ryzen AI Max+ PRO 495, con GPU da 40 CU e bus di memoria a 256 bit. La configurazione da 192 GB è in preordine, con spedizioni previste da novembre 2026. È progettata specificamente per Linux e non offre opzioni Windows: si può scegliere già montata con Fedora oppure in DIY Edition, da completare da sé. Framework pubblica anche quanta memoria usano alcuni modelli sulla sua configurazione di riferimento, e avverte che i numeri cambiano con quantizzazione, contesto e runtime:
| Configurazione | Modello | Quantizzazione | Memoria usata |
|---|---|---|---|
| Ryzen AI Max 385, 32 GB | Qwen3.8-27B | UD-Q4_K_XL | 17,6 GB |
| Ryzen AI Max+ 395, 64 GB | Qwen3.5-122B-A10B | Q3_K_S | 52,5 GB |
| Ryzen AI Max+ 395, 128 GB | DeepSeek V4 Flash 0731 | UD-IQ2_XXS | 90,9 GB |
| Ryzen AI Max+ PRO 495, 192 GB | DeepSeek V4.1 Flash Q2 | Q2 | 163 GB |
Secondo la scheda AMD del Ryzen AI Max+ 395, il processore gestisce al massimo 128 GB di LPDDR5x a 256 bit, ha una grafica Radeon 8060S con 40 core e supporta AVX2. L’elenco di Ollama per Linux comprende i modelli 395, 390 e 385, ma non il PRO 495. La pagina del Framework Desktop non riporta prezzi: li trovi nella nostra notizia sul Framework Desktop da 192 GB.
Mini PC con Ryzen AI Max: AMD Ryzen AI Halo
AMD vende anche un mini PC suo, pensato per chi sviluppa con l’AI. Secondo la pagina di Ryzen AI Halo, ha il Ryzen AI Max+ 395, 128 GB di memoria unificata LPDDR5x e il supporto completo a ROCm, e funziona con Windows o con Linux. AMD dichiara 60 TFLOPS FP16 per la GPU, fino a 50 TOPS per la NPU e modelli fino a 200 miliardi di parametri. Nelle note della pagina il prezzo è di 3.999 dollari. La vendita è esclusiva di Micro Center, come annunciato nel blog di AMD del 20 maggio 2026, e la pagina indica il prodotto in vendita negli Stati Uniti. AMD annuncia come «in arrivo» una versione con Ryzen AI Max+ PRO 495 e supporto fino a 192 GB, senza data né prezzo.
Apple Mac Studio
Le specifiche di Mac Studio prevedono due chip. Con M5 Max si parte da 36 GB di memoria unificata e si arriva a 48, 64 o 128 GB, con una banda di 460 o 614 GBps a seconda della GPU. Con M5 Ultra si parte da 96 GB e si può salire a 256 GB, con 1,2 TBps di banda. La configurazione da 512 GB sarà disponibile da fine ottobre 2026. Ollama usa la GPU dei Mac tramite Metal, mentre i requisiti di LM Studio citano i chip Apple Silicon da M1 a M4. La pagina delle specifiche non riporta i prezzi: li trovi nella nostra notizia sul Mac Studio M5 Ultra.
Quando conviene invece un PC con scheda video
Per decidere, guarda che cosa dice ollama ps. Se i modelli che usi entrano nella VRAM di una scheda supportata, la colonna PROCESSOR segna 100% GPU: il modello è tutto nella memoria delle GPU. Secondo le FAQ di Ollama, un modello caricato su una sola GPU, quando ci entra, di solito va più veloce.
Se invece i modelli che ti interessano non entrano nella VRAM, una parte finisce nella memoria di sistema. È lì che hanno senso i computer a memoria unificata, con 64 GB, 128 GB o più. Prima di comprare conviene fare una prova sul PC che hai già, con nvidia-smi -L e ollama ps.
Se qualcosa va storto
- Dopo una sospensione il modello finisce sulla CPU: su Linux, dopo una sospensione e una ripresa, a volte Ollama non trova più la GPU NVIDIA e passa alla CPU. È un bug del driver: la pagina sul supporto hardware lo aggira ricaricando il modulo del kernel
nvidia_uvm. - GPU AMD supportata solo in parte su Linux: il driver amdgpu incluso nel kernel è più vecchio e potrebbe non supportare tutte le funzioni di ROCm. Ollama consiglia di installare il driver più recente dal sito di AMD.
- GPU AMD via Vulkan non usata: su alcune distribuzioni bisogna aggiungere l’utente
ollamaal grupporender. - Lo script avvisa che Ollama girerà solo su CPU: succede quando non trova una GPU NVIDIA o AMD. Per riconoscerla in automatico gli servono i programmi lspci o lshw.
- Errore 503: il server ha ricevuto troppe richieste. Il numero massimo di richieste in coda si regola con
OLLAMA_MAX_QUEUE.
Documentazione di riferimento
Pagine consultate il 3 e il 4 ottobre 2026:
- Ollama: installazione su Linux, servizio, log e disinstallazione
- Ollama: FAQ
- Ollama: supporto hardware
- Ollama: script d’installazione
- Libreria di Ollama: Llama 3.2
- LM Studio: requisiti di sistema
- Hugging Face Hub: GGUF
- NVIDIA DGX Spark: pagina prodotto
- NVIDIA: blog sul DGX Spark 64GB
- Framework Desktop: pagina prodotto
- AMD Ryzen AI Max+ 395: scheda ufficiale
- AMD Ryzen AI Halo: pagina prodotto
- AMD: blog su Ryzen AI Halo
- Apple Mac Studio: specifiche tecniche