LM Studio: come installarlo e usare un modello AI in locale

LM Studio fa girare i modelli linguistici sul vostro computer, senza mandare le richieste a un servizio esterno. La guida è per chi usa Windows, un Mac con Apple Silicon o Linux. Alla fine avrete scaricato un modello, potrete usarlo in chat dal terminale e avrete un server locale compatibile con le API di OpenAI. Con quel server potete collegare script e programmi già scritti per le API di OpenAI. Quasi tutto il lavoro si fa con lms, lo strumento a riga di comando che arriva insieme all’applicazione. I comandi sono quelli della documentazione ufficiale, elencata in fondo.
Cosa serve
Prima di scaricare qualcosa controllate i requisiti di sistema di LM Studio, perché cambiano da una piattaforma all’altra:
- Mac: chip Apple Silicon (M1, M2, M3 o M4) e macOS 14.0 o successivo. Sono consigliati almeno 16 GB di RAM. Con 8 GB LM Studio potrebbe funzionare lo stesso, ma solo con modelli piccoli e contesti modesti. I Mac con processore Intel per ora non sono supportati.
- Windows: sistemi x64 oppure ARM (Snapdragon X Elite). Sui processori x64 serve il supporto alle istruzioni AVX2. I modelli linguistici consumano molta RAM, quindi ne sono consigliati almeno 16 GB, insieme a una GPU con almeno 4 GB di VRAM dedicata.
- Linux: sistemi x64 o ARM64 (aarch64). LM Studio è distribuito come AppImage. Serve Ubuntu 20.04 o successivo; le versioni di Ubuntu successive alla 22 sono poco testate. Su x64 il supporto AVX2 è incluso di serie.
- Una connessione a internet per scaricare l’applicazione e i modelli. Quando i file dei modelli sono sul disco, LM Studio può lavorare anche del tutto offline.
Fra le distribuzioni Linux la pagina dei requisiti cita soltanto Ubuntu. Se usate Fedora, Arch o un’altra distribuzione, sappiate che le indicazioni ufficiali non la nominano.
Scaricare e avviare LM Studio
Dal sito ufficiale, all’indirizzo lmstudio.ai/download, scaricate il pacchetto per il vostro sistema e installatelo come al solito. Su Linux il pacchetto è un file AppImage. Prima di avviarlo va reso eseguibile: nel file manager apri le proprietà del file e, nella scheda dei permessi, consenti di eseguirlo come programma. Poi avvialo con un doppio clic.
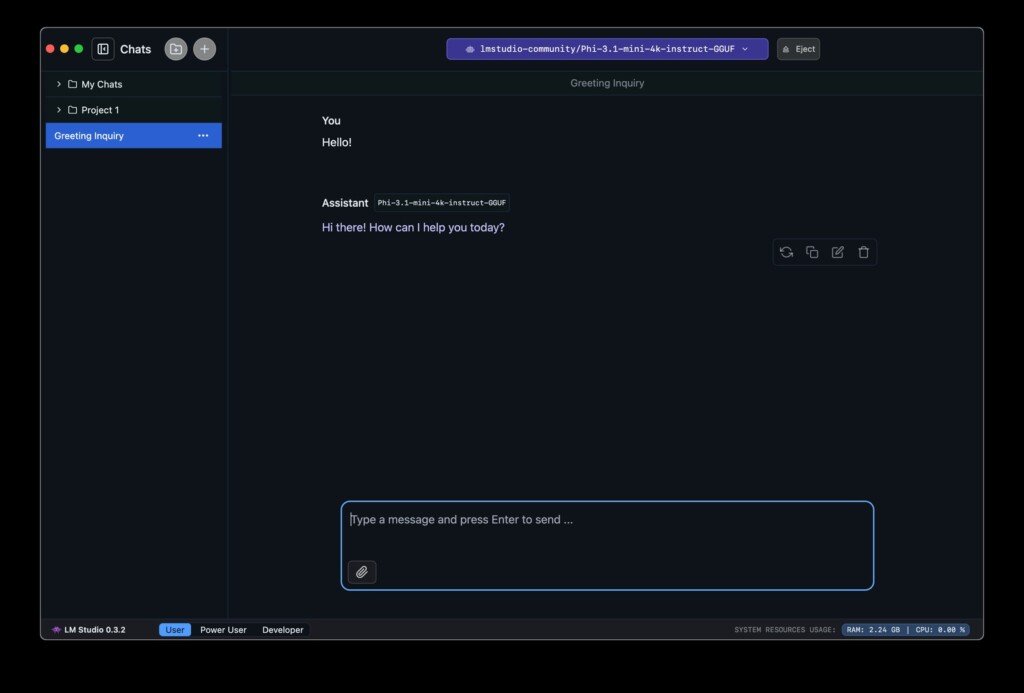
Poi avviate l’applicazione. Da LM Studio 0.2.22 in poi la CLI lms viene installata insieme al programma, quindi non dovete scaricarla a parte.
Controllare che il comando lms funzioni
Aprite un nuovo terminale e scrivete il nome della CLI. Se è installata, lms risponde. È il comando che il README ufficiale di lms indica per verificare l’installazione.
lmsPoi controllate lo stato di LM Studio:
lms statusSe il terminale non trova lms, il README propone un comando che aggiunge la CLI al PATH. Per usarlo servono Node.js e npm.
Fate attenzione prima di lanciarlo. Come ogni comando npx, scarica da internet il pacchetto indicato, in questo caso lmstudio, e lo esegue sul vostro computer. Usatelo solo se lms non viene trovato davvero. Scrivete il nome del pacchetto esattamente come qui sotto: con un errore di battitura potreste scaricare ed eseguire un pacchetto diverso.
npx lmstudio install-cliPoi chiudete il terminale, apritene uno nuovo e lanciate di nuovo lms. Il README chiede espressamente di provare in una nuova finestra di terminale.
Scaricare un modello con lms get
Senza un modello LM Studio non ha niente da far girare. Dal terminale lo scaricate con lms get: il comando cerca nei repository online e salva i file nella cartella dei modelli di LM Studio. Nell’esempio della documentazione si scarica Llama 3.1 da 8 miliardi di parametri:
lms get llama-3.1-8bAlcuni modelli esistono in più quantizzazioni. Per sceglierne una, aggiungete al nome il simbolo @ seguito dalla sigla della quantizzazione. Se lanciate lms get senza il nome di un modello, compaiono i modelli consigliati dalla redazione di LM Studio. Con 8 GB di RAM conviene partire da quell’elenco e scegliere un modello più piccolo.
Finito il download, controllate quali modelli avete sul disco:
lms lsNell’elenco deve esserci il modello che avete appena scaricato.
Chattare con il modello dal terminale
Per provare il modello la strada più rapida è lms chat, che apre una conversazione direttamente nel terminale. Se non indicate un modello, il comando vi chiede di sceglierne uno.
lms chatScrivete una domanda e aspettate la risposta. La pagina di lms chat non spiega come uscire dalla sessione interattiva: chiudetela con la combinazione di tasti che nel vostro terminale interrompe il programma in esecuzione.
Uscire dalla chat non libera subito la memoria. Per impostazione predefinita il modello resta caricato per altri 3600 secondi e nel frattempo occupa RAM. Per vedere quali modelli sono caricati e pronti a rispondere:
lms psCon poca RAM, soprattutto con 8 GB, potete ridurre quel tempo con l’opzione --ttl di lms chat, che indica per quanti secondi il modello resta caricato. Il README riporta anche lms unload --all, che toglie subito dalla memoria tutti i modelli.
Avviare il server compatibile con OpenAI
Il server locale rende raggiungibili via HTTP i modelli caricati e accetta chiamate compatibili con le API di OpenAI. Si avvia dal terminale:
lms server startLa documentazione di lms server status mostra questi messaggi come esempio di avvio riuscito:
Starting server...
Waking up LM Studio service...
Success! Server is now running on port 1234
C’è un dettaglio da tenere presente. Secondo la pagina di lms server start, se non indicate una porta il server riusa l’ultima porta usata. I passaggi successivi presuppongono la porta 1234, quindi controllate su quale porta è partito il server:
lms server statusThe server is running on port 1234.Se dovete leggere lo stato da uno script, potete chiederlo in formato JSON e senza messaggi di log:
lms server status --json --quiet{ "running" : true , "port" : 1234 }Se il server è partito su un’altra porta, fermatelo con lms server stop. Poi riavviatelo con lms server start seguito dall’opzione --port e dal numero 1234, come descritto nella pagina di lms server start.
Per impostazione predefinita il server ascolta solo sull’indirizzo 127.0.0.1, quindi è raggiungibile soltanto dal vostro computer. La stessa pagina avverte che, se lo collegate a un altro indirizzo, il server diventa raggiungibile anche dall’esterno del computer. In quel caso consiglia di attivare l’autenticazione.
Verificare l’endpoint OpenAI con curl
Per controllare che il server risponda davvero, chiedetegli l’elenco dei modelli. Si usa l’endpoint List Models con il metodo GET. Lanciate il comando in un terminale in cui curl è disponibile:
curl http://localhost:1234/v1/modelsLa risposta elenca i modelli visibili al server. Se è attivo il caricamento Just-In-Time, possono comparire tutti i modelli scaricati e non solo quelli già caricati in memoria. Se curl non riesce a collegarsi, ricontrollate stato e porta con lms server status.
Nei programmi e nelle librerie che usano le API di OpenAI impostate come base URL http://localhost:1234/v1. Così le richieste arrivano a LM Studio invece che a un servizio esterno. Come mostra la pagina sulla compatibilità con OpenAI, va cambiato anche il nome del modello: al posto di quello di OpenAI scrivete l’identificatore del modello locale, cioè uno di quelli che restituisce /v1/models.
Fermare il server e disinstallare
Quando il server non vi serve più, fermatelo:
lms server stopPer togliere LM Studio, chiudete l’applicazione e rimuovetela come fate con gli altri programmi del vostro sistema. Su Linux l’applicazione è il file AppImage che avete scaricato. La documentazione ufficiale non descrive la disinstallazione e non dice cosa succede ai modelli e alle impostazioni. I modelli stanno nella cartella dei modelli di LM Studio e possono occupare molto spazio: controllate quella cartella prima di dare per scontato di aver liberato il disco.
Se qualcosa va storto
- Il terminale non trova lms. Aggiungete la CLI al PATH con
npx lmstudio install-cli(servono Node.js e npm), come spiegato sopra. Poi aprite un nuovo terminale e lanciate di nuovolms. - Il server non è sulla porta 1234. Senza l’opzione
--port,lms server startriusa l’ultima porta usata. Controllatela conlms server status. Se è un’altra, fermate il server conlms server stope riavviatelo conlms server startseguito da--porte dal numero 1234. - Mac con processore Intel. LM Studio per ora non li supporta.
- Problemi su versioni di Ubuntu successive alla 22. Queste versioni sono poco testate. Nella pagina dei requisiti gli sviluppatori chiedono di segnalare i problemi aprendo un bug.
- Mac con 8 GB di RAM. LM Studio potrebbe funzionare, ma usate modelli piccoli e contesti modesti; sono consigliati almeno 16 GB.
Documentazione di riferimento
Pagine ufficiali consultate il 1 ottobre 2026:
- LM Studio — Requisiti di sistema
- README ufficiale della CLI lms (GitHub lmstudio-ai/lms)
- LM Studio — lms get
- LM Studio — lms chat
- LM Studio — lms server start
- LM Studio — lms server status
- LM Studio — OpenAI compat: List Models