AI in locale
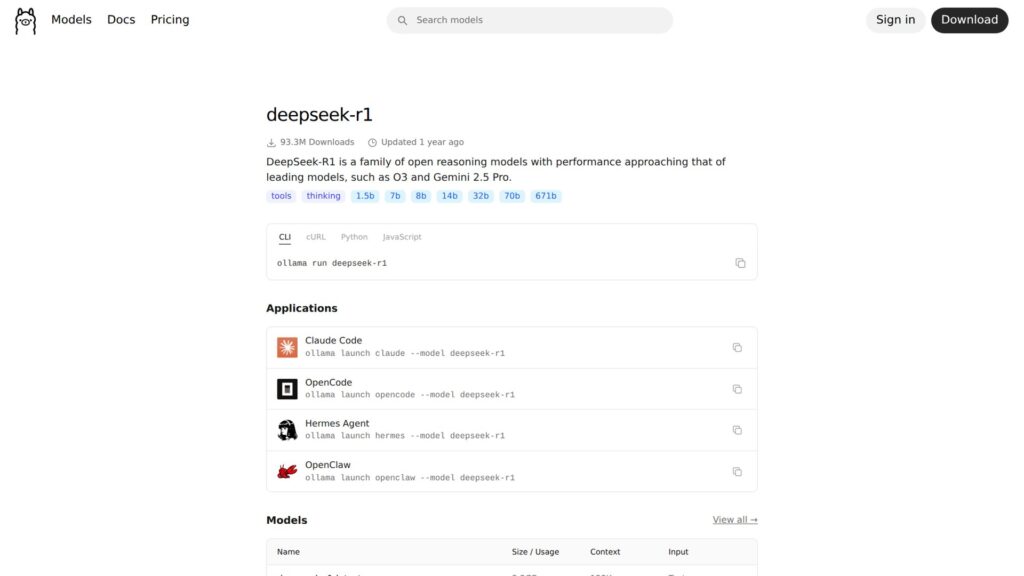
DeepSeek-R1 è una famiglia di modelli di ragionamento con pesi aperti. Con Ollama gira sul vostro PC, quindi le domande non passano da un servizio esterno. Questa guida è per chi ha già Ollama su Linux e vuole capire quale delle sette taglie di DeepSeek-R1 scaricare, come usarla da terminale o via API e come fare in modo che tutto resti in locale. Alla fine avrete un modello DeepSeek installato. Saprete anche controllare se usa la GPU o la CPU e come aggiornarlo o toglierlo. I comandi sono quelli della documentazione ufficiale, elencata in fondo.
Cosa serve
- Un PC Linux con Ollama già installato. Se non c’è ancora, seguite prima la nostra guida Come installare Ollama su Linux e usare un modello in locale.
- Spazio su disco per la taglia che scegliete: si va da 1.1GB per la più piccola a 404GB per il modello completo (la tabella è più sotto). Su Linux i modelli vengono salvati in
/usr/share/ollama/.ollama/models. - Una connessione a Internet per il download: Ollama scarica i modelli dalla rete, poi li esegue in locale.
- Facoltativi: i driver della GPU, cioè CUDA per Nvidia o ROCm per AMD, come spiega la documentazione di Ollama per Linux.
Controllare che Ollama risponda e che il servizio sia attivo
Prima di scaricare qualsiasi cosa conviene controllare che Ollama sia installato e che il suo server sia in funzione. Questo comando chiede al programma la sua versione:
ollama -vSe il terminale dice che il comando non esiste, Ollama non è installato e bisogna partire dalla guida linkata sopra. Se invece l’avete configurato come servizio di sistema, come consiglia la pagina Linux della documentazione, controllatene lo stato con systemd:
sudo systemctl status ollamaIl servizio deve risultare attivo. Se è fermo, avviatelo con questo comando e poi ripetete il controllo:
sudo systemctl start ollamaQuale versione di DeepSeek-R1 scegliere
Nella libreria di Ollama il nome deepseek-r1 raccoglie sette taglie. Solo la 671b è il modello DeepSeek-R1 completo. Le altre sono modelli distillati: il team di DeepSeek ha preso modelli più piccoli e molto diffusi, basati su Qwen e Llama, e li ha addestrati con dati di ragionamento generati da R1.
| Tag Ollama | Dimensione | Contesto | Modello di partenza |
|---|---|---|---|
deepseek-r1:1.5b |
1.1GB | 128K | DeepSeek-R1-Distill-Qwen-1.5B |
deepseek-r1:7b |
4.7GB | 128K | DeepSeek-R1-Distill-Qwen-7B |
deepseek-r1:8b (latest) |
5.2GB | 128K | DeepSeek-R1-0528-Qwen3-8B |
deepseek-r1:14b |
9.0GB | 128K | DeepSeek-R1-Distill-Qwen-14B |
deepseek-r1:32b |
20GB | 128K | DeepSeek-R1-Distill-Qwen-32B |
deepseek-r1:70b |
43GB | 128K | DeepSeek-R1-Distill-Llama-70B |
deepseek-r1:671b |
404GB | 160K | DeepSeek-R1 (modello completo) |
Con i suoi 404GB, la 671b è fuori portata per un PC normale. La pagina ufficiale non dice quanta RAM o VRAM serva per ciascuna taglia. Se non sapete cosa scegliere, partite dalla 1.5b e salite di taglia solo se il PC regge.
Se scrivete solo deepseek-r1, senza taglia, Ollama usa il tag latest, cioè la 8b. Tenete presente che nella libreria di Ollama esistono anche modelli cloud, che non girano sul vostro PC. Per usare DeepSeek offline serve un modello che si scarica sul disco, come le taglie di deepseek-r1 della tabella.
Scaricare DeepSeek-R1 con ollama pull
Il comando pull scarica il modello senza avviarlo, così il download si fa una volta sola mentre c’è la rete. Senza indicare la taglia scarica la versione predefinita, cioè la 8b da 5.2GB:
ollama pull deepseek-r1Finito il download, il modello resta sul disco. Per controllare che ci sia si usa ollama ls, spiegato più avanti.
Avviare la versione più leggera e chattare da terminale
Per una prima prova la 1.5b è la scelta più prudente. Il comando run la avvia e, se non è ancora sul disco, prima la scarica:
ollama run deepseek-r1:1.5bQuando compare il prompt >>> siete dentro la chat: scrivete la domanda e premete Invio. Per un testo su più righe, la CLI Reference spiega che basta racchiuderlo tra tre virgolette (""").
Attenzione: tutto quello che scrivete dopo >>> arriva al modello come una domanda, anche se ha la forma di un comando, e non viene eseguito. Per i comandi delle sezioni successive aprite quindi un altro terminale e lasciate questo alla chat, come fa la documentazione Linux di Ollama quando dice di verificare il server «in un altro terminale».
Un modello usato non sparisce subito dalla memoria: per impostazione predefinita resta caricato per 5 minuti, poi Ollama lo scarica da solo. Per liberare subito la memoria, secondo le FAQ di Ollama, si usa ollama stop seguito dal nome del modello, sempre dal secondo terminale.
Usare la taglia predefinita o una più grande
Nel secondo terminale, se avete già scaricato la versione predefinita con pull, avviatela così:
ollama run deepseek-r1Anche questo comando apre una chat con il prompt >>>. Per provare un’altra taglia usate un terminale libero, non una chat già aperta. Se la 1.5b gira bene, potete salire alla 7b da 4.7GB:
ollama run deepseek-r1:7bOppure alla 14b da 9.0GB:
ollama run deepseek-r1:14bOgni taglia è un modello a parte e occupa il suo spazio su disco. Se ne provate diverse, tenete d’occhio lo spazio libero e togliete quelle che non usate (vedi più avanti).
Interrogare il modello tramite l’API locale
Ollama ha anche un’API HTTP, con cui script e altre applicazioni possono usare il modello. Per impostazione predefinita ascolta solo su 127.0.0.1, porta 11434, quindi risponde al vostro PC e non al resto della rete. L’esempio della pagina di deepseek-r1 usa il tag predefinito, quindi funziona se avete scaricato deepseek-r1 con pull. Lanciatelo in un terminale normale, non dentro la chat:
curl http://localhost:11434/api/chat \
  -d '{
    "model": "deepseek-r1",
    "messages": [{"role": "user", "content": "Hello!"}]
  }'
Se il servizio è attivo e il modello è sul disco, il terminale mostra la risposta. Per usare un’altra taglia basta cambiare il valore di model con un nome che compare in ollama ls.
Usarlo offline e controllare cosa è installato
Le FAQ di Ollama sono chiare: quando si usa un modello in locale, Ollama non vede i prompt né i dati. Diverso è il caso dei modelli ospitati nel cloud di Ollama. Per essere sicuri di non usarli, attivate la modalità solo locale in uno di questi due modi:
- nel file
~/.ollama/server.jsonimpostate"disable_ollama_cloud": true; - impostate la variabile d’ambiente
OLLAMA_NO_CLOUD=1. Se Ollama gira come servizio systemd, le FAQ indicano di aprire la configurazione del servizio consystemctl edit ollama.service, aggiungere la variabile in una rigaEnvironmentsotto[Service], salvare, ricaricare systemd consystemctl daemon-reloade riavviare consystemctl restart ollama, con i permessi di amministratore.
In tutti e due i casi Ollama va riavviato. Da quel momento nei log compare Ollama cloud disabled: true. Si perdono i modelli cloud e la ricerca web.
Per vedere quali modelli ci sono sul disco, con il nome esatto:
ollama lsPer vedere quali modelli sono caricati in memoria in quel momento, e in quale memoria:
ollama psQuesto è l’esempio di output riportato nelle FAQ, con un altro modello:
NAME ID SIZE PROCESSOR UNTIL
llama3:70b bcfb190ca3a7 42 GB 100% GPU 4 minutes from now
La colonna PROCESSOR dice dove è stato caricato il modello:
100% GPU: tutto nella memoria della GPU;100% CPU: tutto nella memoria di sistema;- una ripartizione come
48%/52% CPU/GPU: in parte nella GPU e in parte nella memoria di sistema.
Aggiornare il modello a una nuova revisione
I modelli della libreria possono ricevere aggiornamenti. Per esempio la 8b e la 671b sono passate a DeepSeek-R1-0528, una revisione che secondo la pagina del modello migliora il ragionamento. Il comando qui sotto aggiorna la versione predefinita, deepseek-r1 (la 8b):
ollama pull deepseek-r1Se avete scaricato un’altra taglia, ripetete ollama pull con il nome esatto che compare in ollama ls, compreso il tag dopo i due punti.
Togliere un modello che non serve più
Ogni taglia occupa da uno a decine di gigabyte, quindi conviene eliminare quelle provate e scartate. Nella CLI Reference il comando è ollama rm seguito dal nome del modello. Il nome va scritto esattamente come compare nell’elenco dei modelli installati, per esempio deepseek-r1:1.5b. Prima di cancellare, controllate l’elenco:
ollama lsDopo ollama rm con il nome giusto, rilanciate lo stesso comando: il modello non deve più comparire. Si cancella solo il modello indicato, gli altri restano sul disco.
La licenza di DeepSeek-R1 e dei modelli distillati
Secondo la pagina del modello, i pesi di DeepSeek-R1 hanno licenza MIT, che permette l’uso commerciale, le modifiche e i lavori derivati. I modelli distillati, però, derivano da modelli con una licenza propria:
- quelli basati su Qwen 2.5 (1.5b, 7b, 14b, 32b) derivano da modelli con licenza Apache 2.0;
- la 70b deriva da Llama3.3-70B-Instruct, con licenza llama3.3;
- la sezione sulla licenza cita anche una 8b derivata da Llama3.1-8B-Base, con licenza llama3.1. La stessa pagina però indica che l’attuale tag 8b è DeepSeek-R1-0528-Qwen3-8B: se vi serve per un uso commerciale, verificate la licenza di quella versione.
Se qualcosa va storto
- Ollama non risponde. Controllate il servizio con
sudo systemctl status ollamae, se è fermo, avviatelo consudo systemctl start ollama. Se Ollama gira come servizio, i log si leggono conjournalctl -e -u ollama. - Il download non parte dietro un proxy. Ollama scarica i modelli solo via HTTPS: impostate la variabile
HTTPS_PROXYe installate il certificato del proxy come certificato di sistema. Le FAQ sconsiglianoHTTP_PROXY, perché può interrompere le connessioni dei client al server. - Le risposte perdono il filo sui testi lunghi. Per impostazione predefinita Ollama usa una finestra di contesto di 4096 token. Nella chat la si cambia con
/set parameter num_ctxseguito dal valore. Per tutto il server si usa la variabileOLLAMA_CONTEXT_LENGTH, che nell’esempio delle FAQ vale 8192.
Documentazione di riferimento
Pagine consultate il 29 settembre 2026. La documentazione di Ollama per Linux vale in generale per Linux e non è scritta per una distribuzione in particolare.
- Ollama Library — deepseek-r1 (taglie, dimensioni, modelli distillati, licenza, esempio API)
- Documentazione di Ollama — CLI Reference
- Documentazione di Ollama — Linux
- Documentazione di Ollama — FAQ