ASUS UGen Arc Pro B70: 32 GB ECC per l’AI locale, 128 GB con quattro schede

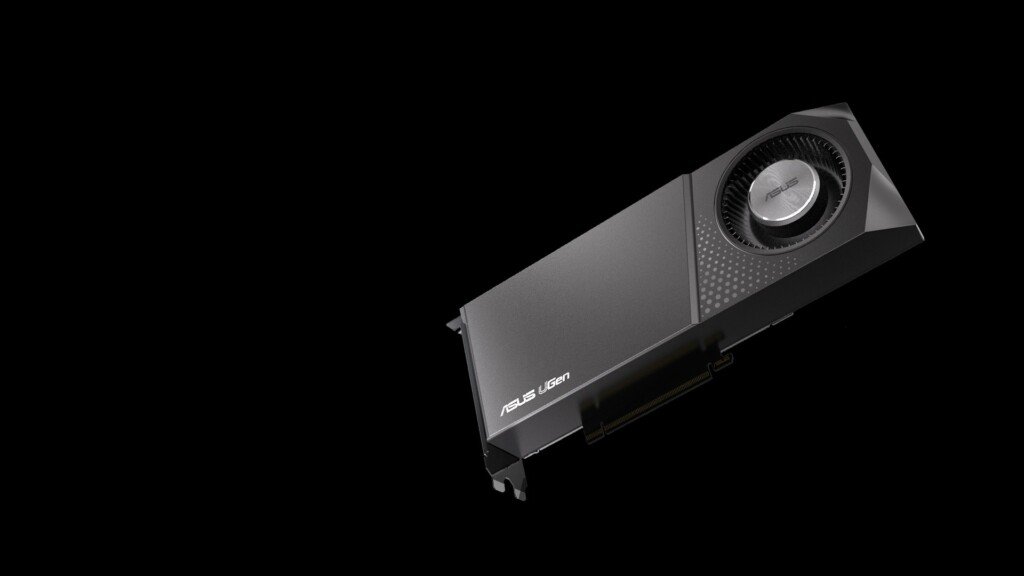
367 TOPS in INT8 con una potenza tipica di scheda (TBP) di 310 W: sono i numeri in testa alla pagina della UGen Intel Arc Pro B70 32GB GDDR6. È un acceleratore per workstation e inferenza AI locale, con 32 GB di memoria ECC. La pagina indica quanta VRAM serve per quali modelli e con quante schede. Prezzo e data di uscita non sono indicati.
Le specifiche della UGen Arc Pro B70
Secondo ASUS la GPU è basata sull’architettura Intel Xe2-HPG e la scheda è full-height a 2 slot, con ventola blower, e misura 267 × 111 × 40 mm per 1,094 kg.
| Caratteristica | Dato dichiarato da ASUS |
|---|---|
| GPU | Intel Xe2-HPG, 32 Xe-Core, 256 motori XMX |
| Render slice / ray tracing | 8 / 32 unità |
| Memoria | 32 GB GDDR6 con ECC, bus a 256 bit, 608 GB/s |
| Frequenza massima | 2800 MHz |
| Prestazioni AI | fino a 367 TOPS (INT8) |
| Potenza tipica (TBP) | 310 W |
| Interfaccia | PCIe Gen5 x16 |
| Uscite video | 3 × DisplayPort 2.1 UHBR13.5, 1 × HDMI 2.1b |
| Alimentazione | un connettore 12V-2×6 |
Il connettore di alimentazione è sul lato lontano della scheda: ASUS lo motiva con il passaggio dei cavi in telai diversi.
Rispetto alla Arc Pro B60: +80% dichiarato, e la memoria
ASUS parla di prestazioni di inferenza fino all’80% superiori rispetto alla Intel Arc Pro B60. La pagina non riporta le condizioni del confronto né le specifiche della B60: il dato resta una dichiarazione del produttore.
Per ASUS la differenza che pesa è la memoria. Più VRAM per scheda vuol dire più KV cache, un contesto più lungo e meno modelli da scaricare sulla RAM di sistema.
Da una a quattro schede: cosa entra in 32, 64 e 128 GB
Con una scheda, ASUS indica che la maggior parte dei modelli sotto i 27 miliardi di parametri sta nei 32 GB. Esempi: Llama 3.x, Qwen 3.x, DeepSeek-R1 Distill e Mistral. Con due schede, 64 GB in totale, si arriva a modelli da 80 miliardi di parametri.
Con quattro schede la VRAM sale a 128 GB, sufficienti secondo ASUS per modelli fino a 120 miliardi di parametri. La pagina avverte che l’abbinamento fra configurazione e modelli è una stima basata sul peso dei modelli più un margine per la KV cache, non una validazione ufficiale Intel.
Secondo ASUS il sistema a quattro schede richiede:
- una scheda madre da workstation con quattro slot x16 distanziati di almeno due slot;
- uno chassis profondo abbastanza da ospitare i 267 mm della scheda più i cavi;
- un alimentatore adeguato: 310 W di TBP per scheda, più il resto del sistema.
Software e sistemi operativi supportati
L’elenco dei software compatibili dichiarato da ASUS è questo:
- vLLM (XPU), indicato come scelta consigliata per la produzione;
- llama.cpp con backend SYCL e Vulkan;
- Ollama, tramite backend oneAPI;
- PyTorch (IPEX), OpenVINO, oneAPI e SGLang.
Su Ollama la pagina è esplicita: il supporto Arc nativo della versione standard è limitato. La via più semplice è llama.cpp con Vulkan, mentre le prestazioni migliori arrivano da llama.cpp SYCL, che richiede oneAPI.
I sistemi operativi supportati, con i driver Intel Arc Pro, sono Windows 11 e Linux (Ubuntu LTS). Per i container su Linux ASUS consiglia le immagini Docker Intel LLM Scaler.
I benchmark che ASUS cita, con le loro condizioni
La pagina riporta risultati di terzi, che variano con configurazione di sistema e modello. Il primo è di Puget Systems con MLPerf Client v1.0 (marzo 2026): 0,08 s al primo token e 123 token/s di generazione dal secondo token. Il modello usato non è indicato.
Il secondo viene da dati Backend.AI, Intel e Lablup (giugno 2026), con vLLM su scheda singola: 1.334 token/s con GPT-OSS 20B e 32 richieste concorrenti.
Garanzia, mercati e a chi si rivolge
ASUS precisa che le specifiche possono cambiare senza preavviso e che i prodotti possono non essere disponibili in tutti i mercati; per l’Italia la pagina non dà informazioni. La garanzia limitata è di 3 anni, con centri di assistenza e gestione RMA in tutto il mondo.
ASUS divide i destinatari per numero di schede:
- sviluppatori e prosumer, con 1 scheda: RAG personale, assistente LLM locale, agente AI, coding;
- piccole imprese e studi creativi, con 2 schede e 64 GB;
- reparti AI aziendali, con 4 schede e 128 GB.