vLLM sulle GPU Intel: llm-scaler 1.5 porta Qwen e Gemma 4

Il 16 ottobre Intel ha pubblicato llm-scaler-vllm PV release 1.5, la nuova versione dell’immagine Docker per far girare modelli linguistici con vLLM sulle proprie GPU (XPU). Come indica la pagina di rilascio su GitHub, la release porta vLLM dalla 0.14.0 alla baseline 0.26.0, con patch Intel per XPU, e PyTorch dalla 2.10 alla 2.12 (build 2.12.0+xpu).
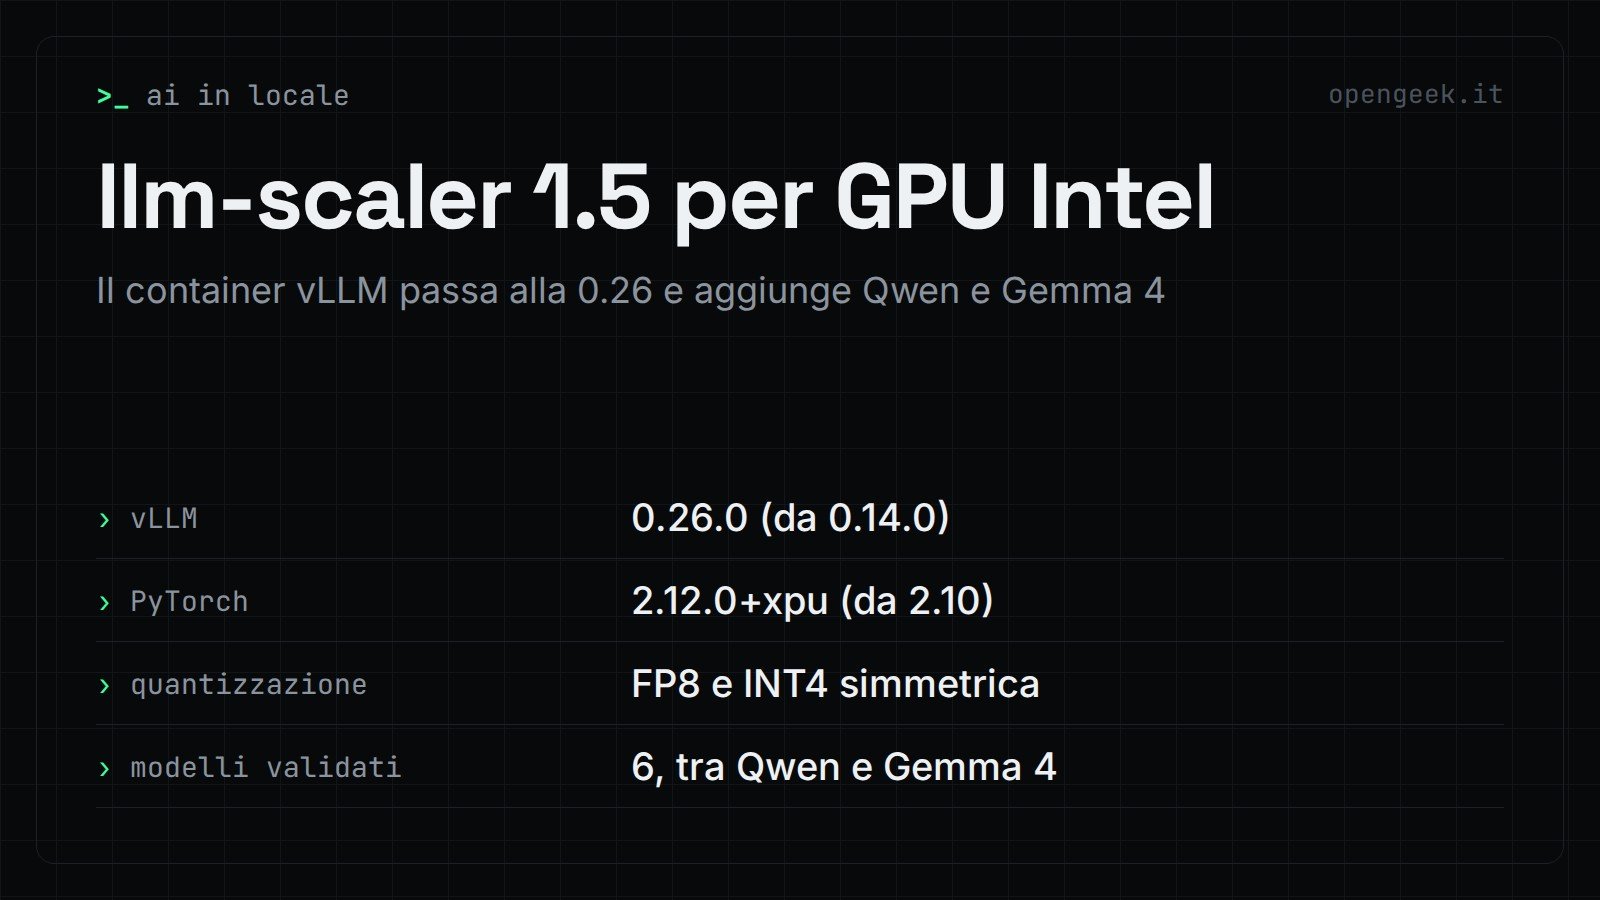
Lo stesso container ora supporta i nuovi modelli Qwen e Gemma 4, la quantizzazione FP8 e INT4 e la KV cache in FP8. L’immagine da usare è intel/llm-scaler-vllm:1.5.
Cosa c’è nell’immagine Docker
Secondo Intel, l’immagine è funzionalmente equivalente a intel/llm-scaler-vllm:0.26.0-b2. Tra i componenti principali:
- Ubuntu 24.04.4 LTS come sistema operativo del container;
- vLLM 0.26.0 con patch Intel XPU e vllm-xpu-kernels 0.1.11.2, anch’esso con patch Intel XPU;
- PyTorch 2.12.0+xpu, Transformers 5.8.0 e Triton XPU 3.7.1;
- compilatore Intel oneAPI DPC++/C++ 2025.3.3.
Modelli supportati e validati
La release amplia la copertura dei modelli Qwen con Qwen3.6-27B, Qwen3.8-27B e Qwen3.6-35B-A3B, e aggiunge il supporto a gemma-4-26B-A4B-it e gemma-4-31B-it. Per i tre Qwen è previsto anche il supporto ai checkpoint block-FP8.
I modelli indicati da Intel come validati sono sei:
- Qwen3.6-27B
- Qwen3.8-27B
- Qwen3.6-35B-A3B
- gemma-4-26B-A4B-it
- gemma-4-31B-it
- Muse-Glimmer-30B
Quantizzazione e KV cache
Sul fronte della precisione numerica, Intel segnala il supporto alla quantizzazione online FP8 e a quella INT4 simmetrica. Viene inoltre abilitata la KV cache in FP8.
MTP, LoRA e DFlash
MTP e serving LoRA sono supportati per Qwen3.6-27B, Qwen3.8-27B, Qwen3.6-35B-A3B, gemma-4-26B-A4B-it e gemma-4-31B-it. DFlash è invece disponibile per Qwen3.6-27B, Qwen3.8-27B, Qwen3.6-35B-A3B e Muse-Glimmer-30B.
Prestazioni e correzioni
Intel dichiara un miglioramento del Time to First Token per i modelli Qwen e Gemma 4, oltre a prestazioni migliori per la decodifica MTP, il serving LoRA e la KV cache FP8. La pagina non riporta cifre né confronti.
Le correzioni elencate nella release:
- prefix caching con MTP;
- output errato dei modelli sym_int4;
- corruzione dell’output block-FP8 durante la decodifica concorrente;
- problemi di accuratezza dei Qwen e del serving LoRA;
- altri bug di caricamento dei modelli e di runtime.
Limiti noti
Secondo Intel, il supporto al grafo XPU è ancora sperimentale. L’inferenza multimodale di Muse-Glimmer richiede Transformers 5.15.0, mentre l’immagine include la 5.8.0. Per configurazioni e limiti specifici di ciascun modello, Intel rimanda alla documentazione release-baseline.