Computer
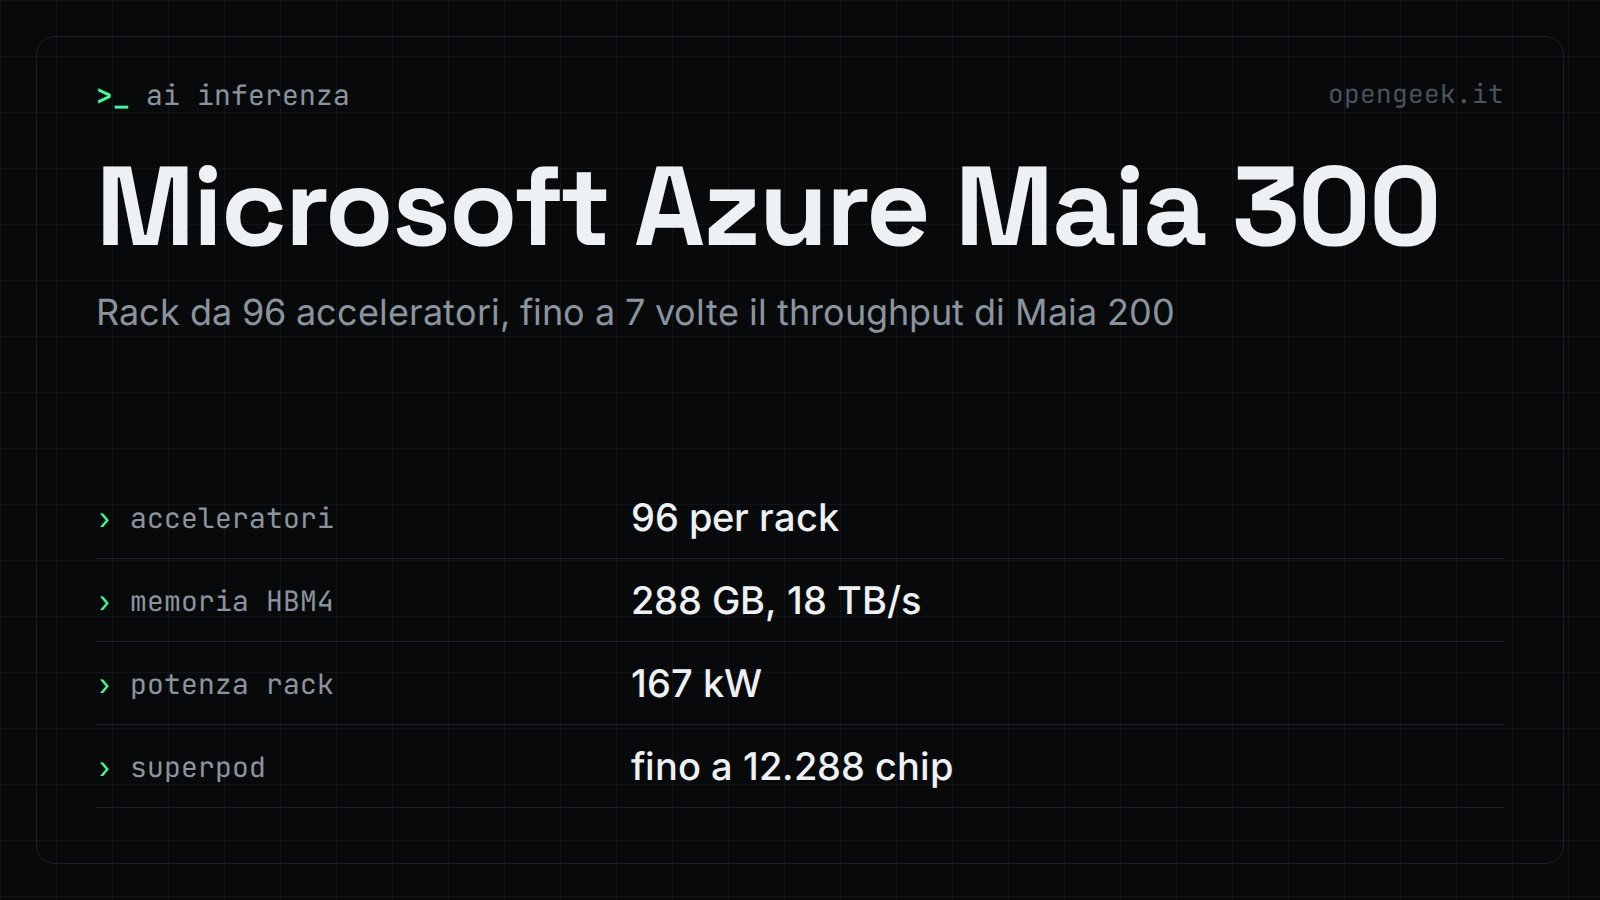
Il 12 ottobre Microsoft ha pubblicato i dettagli di Azure Maia 300, la terza generazione del suo acceleratore progettato per l’inferenza dei modelli linguistici. Nel post tecnico sul blog di Azure l’azienda lo presenta come un sistema con software, silicio, rack, rete e datacenter progettati insieme per i carichi agentici: esecuzioni in più passaggi, decodifica con contesto lungo e uso di strumenti. Rispetto a Maia 200, Microsoft dichiara fino a 7 volte il throughput di token a livello di rack e più di 2,5 volte le prestazioni per watt.
Cosa dichiara Microsoft rispetto a Maia 200
I due numeri principali valgono, secondo Microsoft, per la configurazione completa da 96 acceleratori per rack. Il testo non indica modello, carico né metodologia di misura: sono dati dichiarati dall’azienda.
| Voce | Maia 300 secondo Microsoft |
|---|---|
| Throughput di token a livello rack | fino a 7 volte Maia 200 |
| Prestazioni per watt | più di 2,5 volte Maia 200 |
| Banda di memoria per acceleratore | 2,5 volte Maia 200 |
| Capacità di memoria per acceleratore | +33% rispetto a Maia 200 |
| Banda HBM per watt | circa 2 volte Maia 200 |
| Acceleratori per rack | 96, il doppio di Maia 200 |
Il chip: chiplet, HBM4 e formati a bassa precisione
Il calcolo gira su TSMC N2P, mentre controller di memoria e funzioni di I/O stanno su die separati, ottimizzati per banda, connettività e costo. Microsoft attribuisce a questa scelta multi-chiplet un aumento del 36% dei FLOPs di calcolo, 2,5 volte la banda HBM e il 14% in più di banda scale-up; per FLOPs e scale-up il post non indica il termine di paragone.
- Ogni acceleratore ha otto stack HBM4, per 288 GB di capacità e 18 TB/s di banda, più SRAM su die gestita via software.
- La memoria passa da un’organizzazione uniforme (UMA) a una non uniforme (NUMA) tra i chiplet: il software può piazzare i dati vicino al calcolo che li usa, riducendo l’energia spesa per spostarli.
- Arrivano un MXFP4 migliorato e formati di storage sotto i 3 bit, con conversione dei tipi accelerata in hardware. Servono a ridurre i byte spostati per ogni token e, nello stesso budget di potenza, a sostenere modelli più grandi, contesti più lunghi e più sessioni contemporanee.
Il rack: 96 acceleratori in 167 kW
Il rack di Maia 300 integra 96 acceleratori in 24 tray da quattro, entro 167 kW. Ogni tray include anche processore host, memoria, storage e raffreddamento, quindi non servono tray host separati: lo spazio liberato e la gestione unica di potenza e calore, spiega Microsoft, aumentano l’inferenza per rack.
Il raffreddamento a liquido asporta oltre l’80% del carico termico di acceleratori, regolatori di tensione e switch; memoria, storage e componenti ausiliari restano raffreddati ad aria. Il rack può collegarsi direttamente all’acqua di impianto, oppure usare uno scambiatore di calore nei datacenter raffreddati ad aria. L’alimentazione prevede doppi feed, power shelf e un busbar a 50 V, con commutatore automatico di trasferimento: il rack resta attivo anche se un feed viene spento per manutenzione.
La rete: un solo fabric fino a 12.288 acceleratori
Più rack formano un superpod: fino a 128 rack, per un massimo di 12.288 acceleratori. Dentro il rack i collegamenti sono elettrici, per contenere consumi e costi; tra i rack c’è un secondo livello di switch ottici. Il trasporto è un protocollo AI personalizzato basato su Ethernet.
Il modello di comunicazione è lo stesso nel pod e nel superpod, e ogni acceleratore può parlare con qualsiasi altro senza passare dall’host né da una NIC scale-out. Microsoft indica fino a 750 GB/s verso un altro acceleratore del superpod, quando solo un sottoinsieme degli acceleratori comunica tra rack. Le distanze sono di tre tipi: la coppia collegata direttamente ha la latenza più bassa, gli acceleratori dello stesso pod sono a un salto di switch, quelli di un altro pod a tre salti.
Dove arriverà e cosa non dice Microsoft
Microsoft collega Maia 300 ai prodotti che già gestisce su larga scala, tra cui Microsoft Copilot, GitHub Copilot e Microsoft Foundry, con l’obiettivo di massimizzare i token utili per watt e per dollaro. Il post non indica date di disponibilità, regioni Azure, prezzi o clienti esterni, e non dice nulla sull’Italia. L’azienda annuncia altre informazioni a Microsoft Ignite 2026, a San Francisco e online, a novembre.
Dove si colloca rispetto agli altri annunci per l’inferenza
Nelle stesse settimane altri produttori hanno presentato hardware per l’AI nei datacenter, ma i dati non sono confrontabili: prodotti e condizioni di misura sono diversi. Secondo Intel, la GPU D-series (nome in codice Crescent Island, ne abbiamo scritto qui) offre fino a 480 GB di LPDDR5X, 1,5 TB/s e 1,3 petaflops FP8 in 350 W, in formato PCIe raffreddato ad aria; la scheda Intel ha 160 GB, i 480 GB sono per le schede dei partner. NVIDIA ha invece contribuito all’Open Compute Project i progetti dei rack Vera Rubin: la specifica MGX 1.2, raffreddata a liquido, supporta rack fino a 250 kW (il nostro pezzo).