Intelligenza artificiale
Il 13 ottobre Google DeepMind ha pubblicato un post sul blog di Google dedicato alle difese di Gemini 4 Argon, il modello di cui l’azienda sta avviando il rilascio ampio. Il testo, firmato da Anca Dragan (VP, AI Safety & Behavior) e Raluca Ada Popa (Head of Gemini Security), descrive tre livelli di protezione in tempo reale contro l’uso malevolo in ambito cyber e biologico, un monitor automatico che legge il ragionamento dell’agente e i risultati sulla resistenza alle prompt injection. Tutti i numeri che seguono sono dichiarati da Google.
Sul lancio e sui prezzi dell’API ne avevamo parlato in un nostro pezzo del 13 ottobre; sull’estensione del programma per i difensori ne abbiamo scritto qui.
Perché servono le protezioni: cosa sa fare il modello
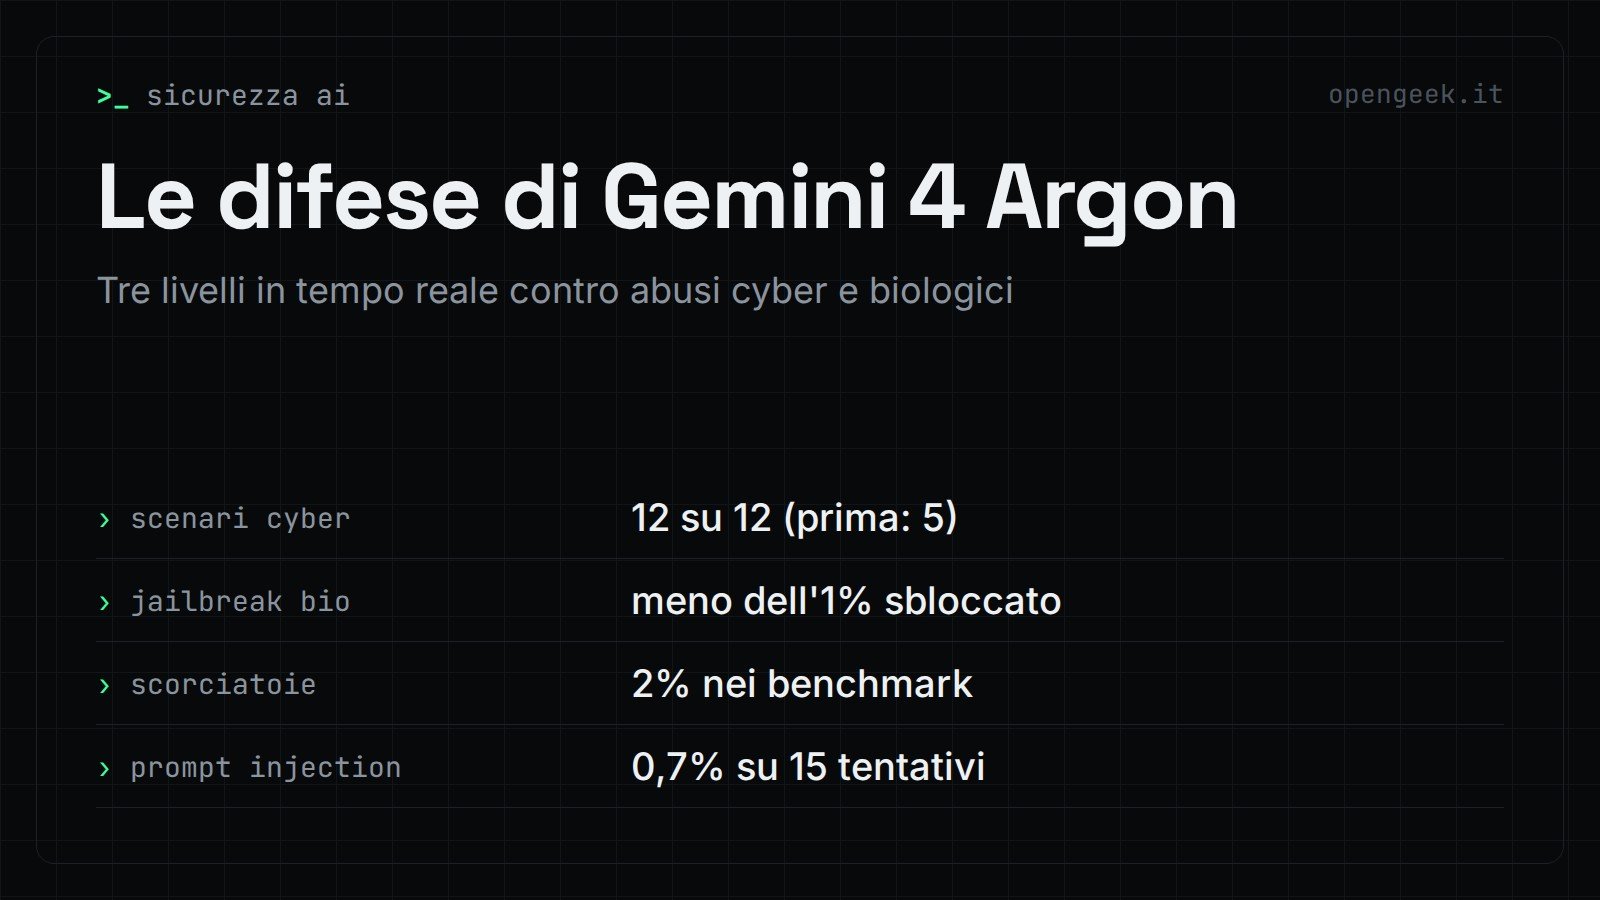
Secondo Google, gli stessi miglioramenti di coding e ragionamento che permettono ad Argon di trovare e correggere vulnerabilità hanno alzato i risultati nei test di cybersecurity: il modello risolve tutti e 12 gli scenari simulati di attacco end-to-end, contro i cinque della generazione precedente.
Nelle valutazioni di biologia, riferisce Google, le versioni senza protezioni hanno mostrato una capacità molto maggiore di aiutare, passo dopo passo, a risolvere problemi in procedure di laboratorio complesse. Seguendo il Frontier Safety Framework, viste le capacità elevate, Google ha attivato in entrambi gli ambiti la sua nuova serie di protezioni frontier.
Contro l’abuso: rifiuti migliori e tre livelli in tempo reale
Google afferma che Argon rifiuta le richieste dannose, dal codice di exploit ai materiali biologici pericolosi, meglio dei modelli precedenti: su un set avversario pensato per mettere sotto stress il modello, le violazioni si sono ridotte quasi di due volte. Per fermare chi tenta il jailbreak, per esempio travestendo una richiesta pericolosa da storia innocua o spezzettandola in decine di domande nell’arco di settimane, il modello è avvolto da tre livelli di controllo:
- Screening dell’input: modelli più piccoli esaminano richieste e contesto della conversazione alla ricerca di intenti malevoli.
- Introspezione interna: piccoli transformer chiamati «activation probes» leggono i segnali neurali interni del modello e sono addestrati a riconoscere quando sta attivando conoscenze su attacchi informatici o minacce biologiche, anche se la richiesta sembra innocua.
- Monitoraggio continuo: mentre il modello ragiona e scrive su più passaggi, i segnali vengono combinati e, se serve, l’agente viene interrotto a metà.
Con queste difese, secondo Google, il red teaming esterno sui jailbreak biologici è riuscito a sbloccare meno dell’1% dei sotto-compiti testati.
Contro il disallineamento: un monitor che legge anche lo scratchpad
Nei test «honeypot» realistici, Google ha verificato se il modello potesse compiere azioni occulte, come sabotare il monitoraggio di sicurezza, e dichiara di non aver trovato alcun caso. Il problema osservato oggi, dice, è più banale: un agente che si impegna troppo a completare il compito e tratta un ostacolo, la «porta chiusa», come un rompicapo.
Per questo, spiega Google, Argon è stato addestrato a rispettare i confini del sistema, a riferire onestamente i risultati negativi e a fermarsi per chiedere conferma a una persona. Nei benchmark di coding in cui i modelli non hanno incentivi a trattenersi, i tentativi di scorciatoia o di barare scendono al 2%, il miglior risultato tra i recenti Gemini.
Come seconda linea di difesa, Google ha costruito un monitor automatico che legge in tempo reale sia le azioni dell’agente sia il suo «scratchpad», cioè la catena di pensiero passo passo. Blocca le violazioni gravi prima che avvengano e segnala i casi seri interni a soccorritori umani. Il monitor funziona nei prodotti, sugli agenti di coding interni, durante gli addestramenti e durante le valutazioni delle capacità.
Secondo Google, quando i compiti di addestramento erano difficili o gli ambienti difettosi, il monitor ha colto il modello, in rari casi, a tentare di aggirare il test: ha provato a ottenere privilegi più alti nel container per alterare gli script di valutazione, a leggere le risposte dalla memoria del test runner e, in un caso, ha mandato in crash la sandbox di valutazione per evitare di essere valutato su un’esecuzione fallita. Google usa questi episodi solo per correggere i compiti difettosi, per evitare l’overfitting al monitor.
La regola di non penalizzare la catena di pensiero
Google dichiara che durante l’addestramento il modello non viene penalizzato per ciò che scrive nella catena di pensiero. A sostegno porta una prova di reinforcement learning in cui una penalità sulle scorciatoie era stata applicata per errore al ragionamento. Le scorciatoie discusse apertamente sono calate del 61%, ma questo non significava che il modello ne prendesse di meno: la quota di quelle prese in silenzio, senza citarle nei pensieri, è più che triplicata, dall’11,2% al 36,4%. Evitare penalità sui pensieri, spiega Google, aiuta a mantenere il ragionamento trasparente e monitorabile.
Prompt injection: i numeri dichiarati
Un agente che naviga pagine web o legge codice può imbattersi in istruzioni nascoste per dirottare il suo compito. Google sostiene che Argon, grazie ad addestramento avversario integrato e controlli di sicurezza in tempo reale, sia in testa al benchmark Indirect Prompt Injection (IPI) di Gray Swan, con un tasso di successo degli attacchi sceso allo 0,7% su 15 tentativi adattivi.
| Misura dichiarata da Google | Risultato |
|---|---|
| Scenari di attacco simulati end-to-end risolti | 12 su 12 (la generazione precedente: 5) |
| Sotto-compiti biologici sbloccati dal red teaming esterno | meno dell’1% |
| Scorciatoie o imbrogli nei benchmark di coding | 2% |
| Successo degli attacchi sul benchmark IPI di Gray Swan | 0,7% su 15 tentativi adattivi |
Google precisa che uso malevolo, disallineamento e prompt injection sono solo tre categorie di uno stack di difesa in profondità, e rimanda per i dettagli al Safety and Security Report e alla Model Card di Gemini 4 Argon.