Computer
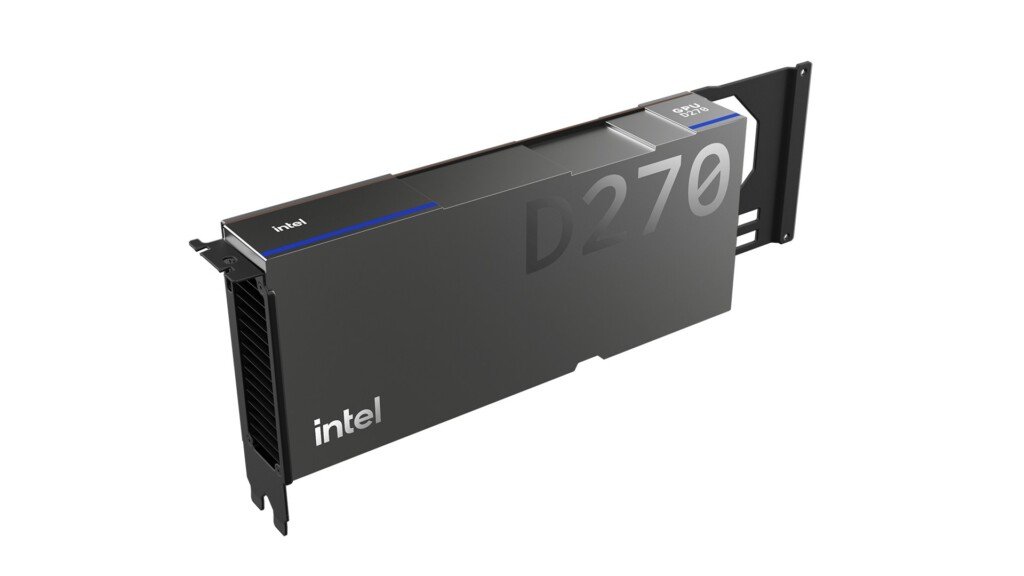
All’Open Compute Project (OCP) Global Summit Intel ha diffuso nuovi dettagli tecnici sulla GPU D-series, in precedenza nota con il nome in codice Crescent Island. Ha inoltre presentato rack basati su Xeon e novità sul software aperto. Secondo il comunicato di Intel, la scheda è pensata per l’inferenza AI, è costruita sull’architettura Xe3P ed è già in campionamento presso i clienti. Prezzo e data di disponibilità non sono stati indicati.
GPU D-series: le specifiche dichiarate da Intel
Intel descrive la GPU D-series come una soluzione per rendere più sostenibile l’inferenza prolungata e ad alto consumo di memoria. I dati forniti dall’azienda:
- architettura Xe3P, la più recente di Intel;
- fino a 480 GB di memoria LPDDR5X;
- 1,5 TB/s di banda di memoria;
- 1,3 petaflops di calcolo FP8;
- potenza entro i 350 watt;
- modelli fino a 300 miliardi di parametri su una singola scheda e oltre 1.000 miliardi di parametri in un sistema a otto GPU.
Una nota a piè di pagina chiarisce il dato sulla memoria: la scheda PCIe a marchio Intel ha 160 GB di LPDDR5X, mentre il progetto permette ai partner ODM di realizzare schede con marchio proprio e opzioni flessibili fino a 480 GB. Intel precisa anche che le prestazioni variano in base a uso e configurazione.
Per i data center esistenti: PCIe, aria e base software comune
La scheda ha un formato PCIe standard e un raffreddamento ad aria. Con la base software Xe comune, dice Intel, dovrebbe semplificare l’installazione nei data center già attivi. Permette inoltre di portare le applicazioni tra le piattaforme GPU Intel e di far crescere l’inferenza senza rack o impianti di raffreddamento dedicati.
Intel cita come applicazioni i modelli linguistici di grandi dimensioni, i contesti lunghi, i servizi di inferenza concorrenti, i servizi AI multi-tenant, la robotica e altri carichi sensibili alla latenza. Per portarla in produzione l’azienda collabora con OEM, ODM, neocloud, produttori di software, fornitori di appliance e aziende AI-native.
Rack Xeon 6+ per gli agenti AI
Sul fronte CPU, Intel sostiene che i flussi di lavoro agentici richiedano molto calcolo generico: orchestrazione, elaborazione dati, gestione dell’I/O ed esecuzione dei compiti che tengono impegnati gli acceleratori. Per l’azienda la prestazione di un’infrastruttura si misura sempre più in agenti concorrenti per rack a una latenza obiettivo.
Con i partner Intel ha mostrato rack basati su Xeon, molti dei quali sullo standard Open Rack v3 (ORv3) dell’OCP. Alcune configurazioni selezionate di Xeon 6+ superano i 46.000 core per rack, con una potenza totale di 133,45 kW. Cifre dichiarate da Intel per configurazioni specifiche.
Software: integrazione upstream e supporto ai nuovi modelli
La strategia software punta sull’integrazione diretta nei framework AI, nei runtime di inferenza e negli ambienti di distribuzione standard, su CPU e GPU. Gli stessi framework servono l’inferenza e le applicazioni agentiche su Xeon. Intel lavora al supporto «Day 0» per i nuovi modelli aperti su GPU D-series e Xeon: l’esempio recente è Muse Glimmer di Meta.
L’Intel AI for Enterprise Agent Toolkit è già ottimizzato e distribuibile su Xeon. La sua architettura a provider è pensata per estendersi anche alle GPU Intel.
Dove si colloca rispetto ad AMD Helion e al rack Vera CPU di NVIDIA
Secondo il comunicato di AMD, il 12 ottobre l’azienda ha presentato Helion, un blueprint aperto basato su specifica OCP. Prevede un rack solo CPU con EPYC di sesta generazione fino a 32.768 core e un rack all-in-one con nodi EPYC e GPU Instinct MI350P. AMD prevede le configurazioni a novembre 2026; ne avevamo scritto qui.
NVIDIA, come racconta il blog dell’azienda, ha presentato per l’OCP un rack Vera CPU basato sull’architettura MGX, per chiamata di strumenti, orchestrazione ed esecuzione in sandbox degli agenti. Sui rack Vera Rubin abbiamo già pubblicato un approfondimento.