AI in locale
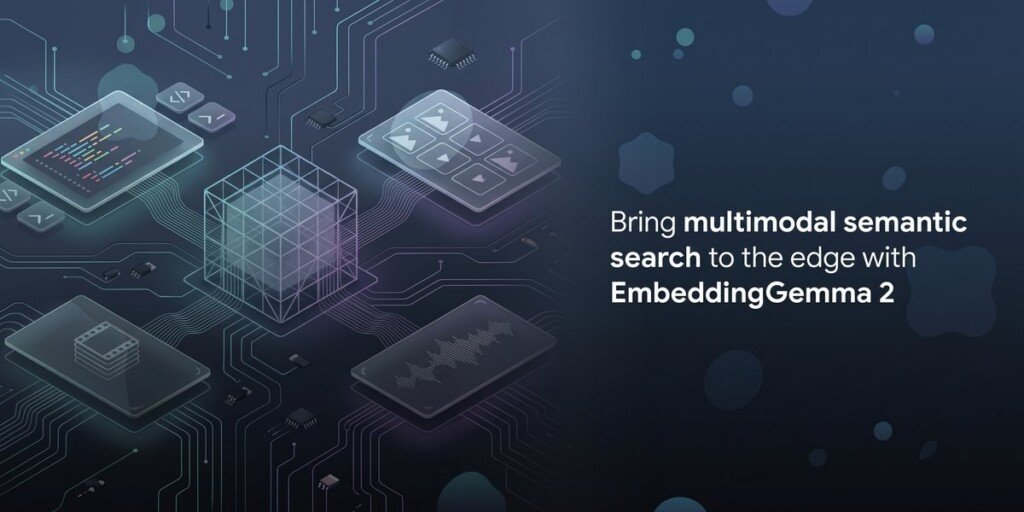
Il 6 ottobre 2026 Google DeepMind ha annunciato EmbeddingGemma 2, un modello di embedding open-weight e multimodale che porta testo, immagini, fotogrammi video e audio in un unico spazio vettoriale. Secondo il post sul blog Google Developers ha 740 milioni di parametri ed è pensato per applicazioni locali e orientate alla privacy. Arrivano anche due demo nell’app Google AI Edge Gallery e Google AI Edge Foresight, un’app sperimentale per Mac che assiste nelle riunioni anche offline.
Un solo modello al posto di tre
Google sostiene che EmbeddingGemma 2 riduca latenza e consumo di memoria rispetto a una catena di modelli separati per descrizione delle immagini, trascrizione vocale ed embedding del testo. Gli encoder sono modulari: si caricano solo quelli che servono, per esempio testo e visione per cercare foto e video, e si attiva l’audio quando arrivano note vocali.
Su un Pixel 11 Pro, secondo l’azienda, bastano circa 191 MB di RAM attiva per i soli pesi testuali e circa 567 MB per il modello multimodale completo.
Il modello come motore decisionale
Google indica anche un uso come motore decisionale: il modello confronta l’input dell’utente con etichette e descrizioni di classificazione, senza dati di addestramento né fine-tuning, per un instradamento delle intenzioni in pochi millisecondi. Nella demo con una partita a scacchi, il Decision Task di MediaPipe valuta 500 opzioni a ogni turno con meno di 100 ms di risposta.
Le due demo in Google AI Edge Gallery
Google AI Edge Gallery, l’app per provare modelli on-device, aggiunge due showcase:
- Instant Media Search: cerca foto e video locali con linguaggio naturale o con un’immagine di esempio. Query e contenuti diventano vettori calcolati sul dispositivo, quelli dei contenuti sono salvati in un database SQLite locale e i risultati si ordinano per similarità del coseno, aggiornandosi a ogni tasto premuto, senza connessione. Le query possono essere in più lingue: Google mostra esempi in tedesco, come «Katze schläft auf Tastatur».
- Video Moments Finder: indicizza fotogrammi e blocchi audio di un video locale e, con descrizioni come «kids laughing» o «dog catching a frisbee», evidenzia i punti esatti in cui compaiono, senza trascrivere l’audio né generare didascalie.
L’app si scarica da Google Play Store o Apple App Store; il codice di riferimento è su GitHub.
Foresight per Mac: appunti e ricerca offline
Google descrive Foresight come una compagna di riunione sensibile al contesto. Usa EmbeddingGemma 2 e i modelli Gemma 4, elabora tutto in locale e si collega all’audio di sistema e al microfono, quindi funziona con qualsiasi piattaforma di meeting, anche offline.
- arricchisce gli appunti abbreviati con dettagli ricavati in tempo reale dalla conversazione;
- cerca in linguaggio naturale tra immagini, documenti, trascrizioni e note;
- mantiene i dati sul dispositivo, senza costi di abbonamento al cloud.
Come integrarlo: ML Kit, MediaPipe e LiteRT
| Strumento | Cosa offre secondo Google |
|---|---|
| ML Kit (Android) | Servizio annunciato come in arrivo nelle settimane successive al post del 6 ottobre, con accelerazione NPU quando disponibile e aggiornamenti automatici del modello |
| MediaPipe Tasks | Supporto per iOS, macOS, Windows, Linux e Web; Universal Embedder, Semantic Retriever e Decision Task |
| LiteRT | Controllo fine su elaborazione e accelerazione su CPU, GPU e NPU; un unico file .litertlm per CPU e GPU |
L’Universal Embedder gestisce ridimensionamento delle immagini, normalizzazione dei tensori e tokenizzazione, e restituisce vettori normalizzati a 768 dimensioni, o troncati tra 128 e 512. Il Semantic Retriever indicizza gli embedding sul dispositivo e risponde con ricerche approssimate dei vicini più prossimi in tempi a una cifra di millisecondi.
Prestazioni e ottimizzazioni
Con un budget massimo di 70 token di visione per immagine, Google indica 37,3 ms per un embedding visivo (26,9 immagini al secondo) sulla GPU di un MacBook M5 Pro. Una tabella con altri dispositivi, su CPU, GPU e NPU, è nel post.
- Quantization-Aware Training: pesi compressi in INT4 e INT8, per portare la ricerca vettoriale multimodale su hardware di fascia media.
- Grafo di calcolo scelto a runtime in base alla dimensione di testo e immagine, con budget di token visivi regolabile per bilanciare latenza e precisione.
- Matryoshka Representation Learning: lo slicing permette di troncare le dimensioni dei vettori al volo, riducendo lo spazio occupato dall’archiviazione locale e dagli indici.
Dove scaricarlo e provarlo
I pacchetti .litertlm già quantizzati si scaricano dalla LiteRT Community su Hugging Face, dove sta anche la scheda del modello con le piattaforme supportate e i benchmark. Google segnala inoltre un Colab, una guida su GitHub e la possibilità di misurare le prestazioni su oltre 200 dispositivi reali nel Developer Device Platform di Google Cloud; c’è anche una demo web senza installazione. Il post non indica prezzi né disponibilità specifiche per l’Italia.