AI in locale
CLM-v0.1-8B: il modello di Stanford che sceglie azioni senza generare testo
Contrastive-LM, il progetto dei ricercatori di Stanford, ha pubblicato CLM-v0.1-8B, un modello con pesi e codice rilasciati con licenza Apache 2.0. Non genera testo: dato uno «stato» e un insieme di azioni candidate, assegna a ciascuna un punteggio e sceglie la migliore. Secondo il repository ufficiale su GitHub, nei compiti zero-shot di computer-use, gaming e tool-calling rende quanto Jev con una latenza fino a 9 volte inferiore.
Cos’è un Contrastive Language Model
Il progetto lo definisce un modello «System One»: una classe addestrata con un obiettivo contrastivo che collega stati e azioni. CLM-8B è composto da due piccole teste di proiezione, una per lo stato e una per l’azione, montate su un encoder Qwen3-8B congelato. Ogni testa è un modulo da 20 milioni di parametri addestrabili.
In uso, l’encoder produce un embedding per ogni testo nuovo e il modello calcola un prodotto scalare con i candidati già in cache. Una domanda tipizzata è uno stato più un insieme chiuso di azioni, e un softmax sui punteggi dà la distribuzione delle risposte.
Come è stato addestrato
L’addestramento procede in tre fasi, descritte nel repository e nella scheda del modello su Hugging Face:
- pre-training su circa 60 milioni di coppie domanda-risposta Nemotron;
- mid-training su circa 30 milioni di hard negative sintetici, cioè risposte simili ma sbagliate generate con Gemini 2.5 Flash-Lite;
- post-training su circa 1 milione di traiettorie di agenti, dal dataset Agent Data Protocol più tracce di terminale.
Il post-training mescola il 40% di replay Nemotron e il 60% di traiettorie agentiche. Con il replay l’accuratezza top-1 sugli hard negative passa da 69% a 68,5%; con soli dati agentici scende a 56,2%. Su circa 100.000 domande di test il solo pre-training arriva al 52,1% e una breve fase con hard negative porta al 69,2%.
Velocità e benchmark dichiarati
Il vantaggio di velocità è massimo, spiega il repository, quando i candidati sono molti (WikiRacing) o quando le azioni si riusano tra stati diversi (il gioco T-Rex, incluso negli esempi). Con circa mille candidati la scheda su Hugging Face indica un modello 13 volte più veloce di Jev.
Come verificatore, dopo un fine-tuning leggero, CLM raggiunge 81,6% su DeepSWE (38 task tenuti fuori dall’addestramento) e 87,6% su Terminal-Bench 2.1 (30 task). Le soluzioni candidate sono state campionate con Opus 5 per DeepSWE e con Fable 5 per Terminal-Bench. La latenza è misurata su H100 ed è 4,1–5,7 volte inferiore a quella di Jev. Il repository precisa che Jev, su questi compiti a lungo orizzonte, non funziona da verificatore e resta sotto il pass@1.
I numeri sui benchmark agentici vengono dalle teste con fine-tuning, non dal checkpoint usato zero-shot, avverte la scheda del modello.
La cache dei vettori
Il server riserva all’avvio una porzione di memoria del dispositivo per gli embedding di stati e azioni. Le misure, effettuate su una RTX 4090 con set di azioni fisso, riportano la latenza p50 lato server, prima senza e poi con la cache:
| Scenario | 3 azioni | 50 azioni |
|---|---|---|
| Stato nuovo a ogni chiamata | da 28,6 a 28,0 ms | da 28,8 a 28,1 ms |
| Stati rivisitati (20 stanze) | da 1,7 a 0,6 ms | da 2,0 a 0,7 ms |
| Uno stato ripetuto | da 1,7 a 0,6 ms | da 2,0 a 0,7 ms |
Un ciclo che rivisita gli stati risponde quindi circa 2,8 volte più in fretta; uno che non si ripete paga comunque l’encoder.
Come provarlo in locale
Il pacchetto si installa con pip install contrastive-lm. Servono due processi: l’encoder Qwen3-8B servito da vLLM in modalità pooling (porta 8090) e il comando clm-serve, che espone l’API sulla porta 8700 e scarica al primo avvio la testa di riferimento da 75 MB. Gli stati oltre 2048 token vengono troncati, a meno di alzare entrambi i limiti, con più memoria GPU.
- L’endpoint
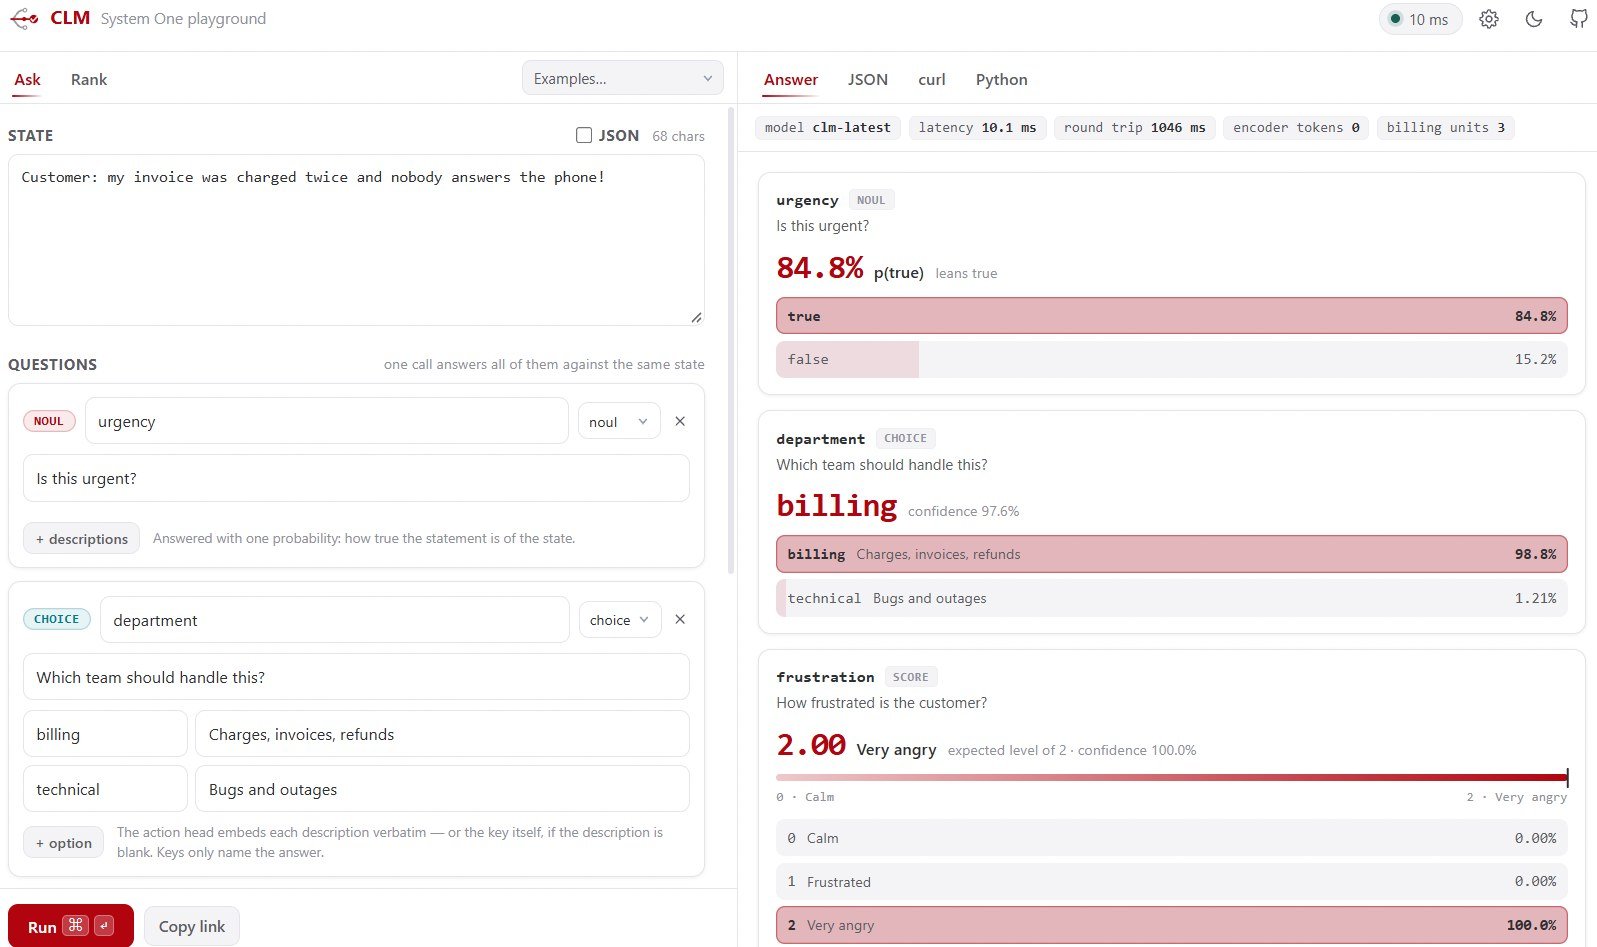
/v1/systemoneaccetta domande di tipo Noul (vero/falso con probabilità), Choice (scelta tra opzioni) e Score (livello atteso su una scala). - L’endpoint
/v1/rankordina candidati liberi, per esempio risposte best-of-N o nomi di strumenti. - Alla radice del server c’è un playground web;
--no-uilo disattiva. - Il fine-tuning, che addestra solo le teste, è descritto in
docs/FINETUNING.md.
Limiti dichiarati e prossimi passi
La scheda su Hugging Face elenca i limiti: le teste funzionano solo con gli embedding a ultimo token di Qwen3-8B, il modello non genera ma valuta solo i candidati forniti, e le probabilità sono relative a quell’insieme. La lingua indicata nella scheda è l’inglese; sull’italiano non ci sono informazioni.
Secondo la stessa scheda, un CLM-35B multimodale, con più dati, calcolo e parametri, è in arrivo a inizio ottobre. La roadmap del repository cita anche esperimenti di scaling, supporto a visione e multimodalità per robotica e computer-use, e un ampliamento della ricetta dati.