Qwen4-Max-Preview di Alibaba: 1M token, ma solo fino al 25 novembre

Si può dare a Qwen4-Max-Preview uno screenshot, un documento o un video da analizzare, oppure un compito di programmazione che richieda strumenti e ricerca web. Sono i casi d’uso che Alibaba cita per il nuovo modello di punta della famiglia Qwen. Secondo la pagina ufficiale di Alibaba Cloud, l’anteprima è aperta dalle 10:00 dell’11 novembre 2026 e si usa solo con una chiave API dedicata di Token Plan, non a consumo.
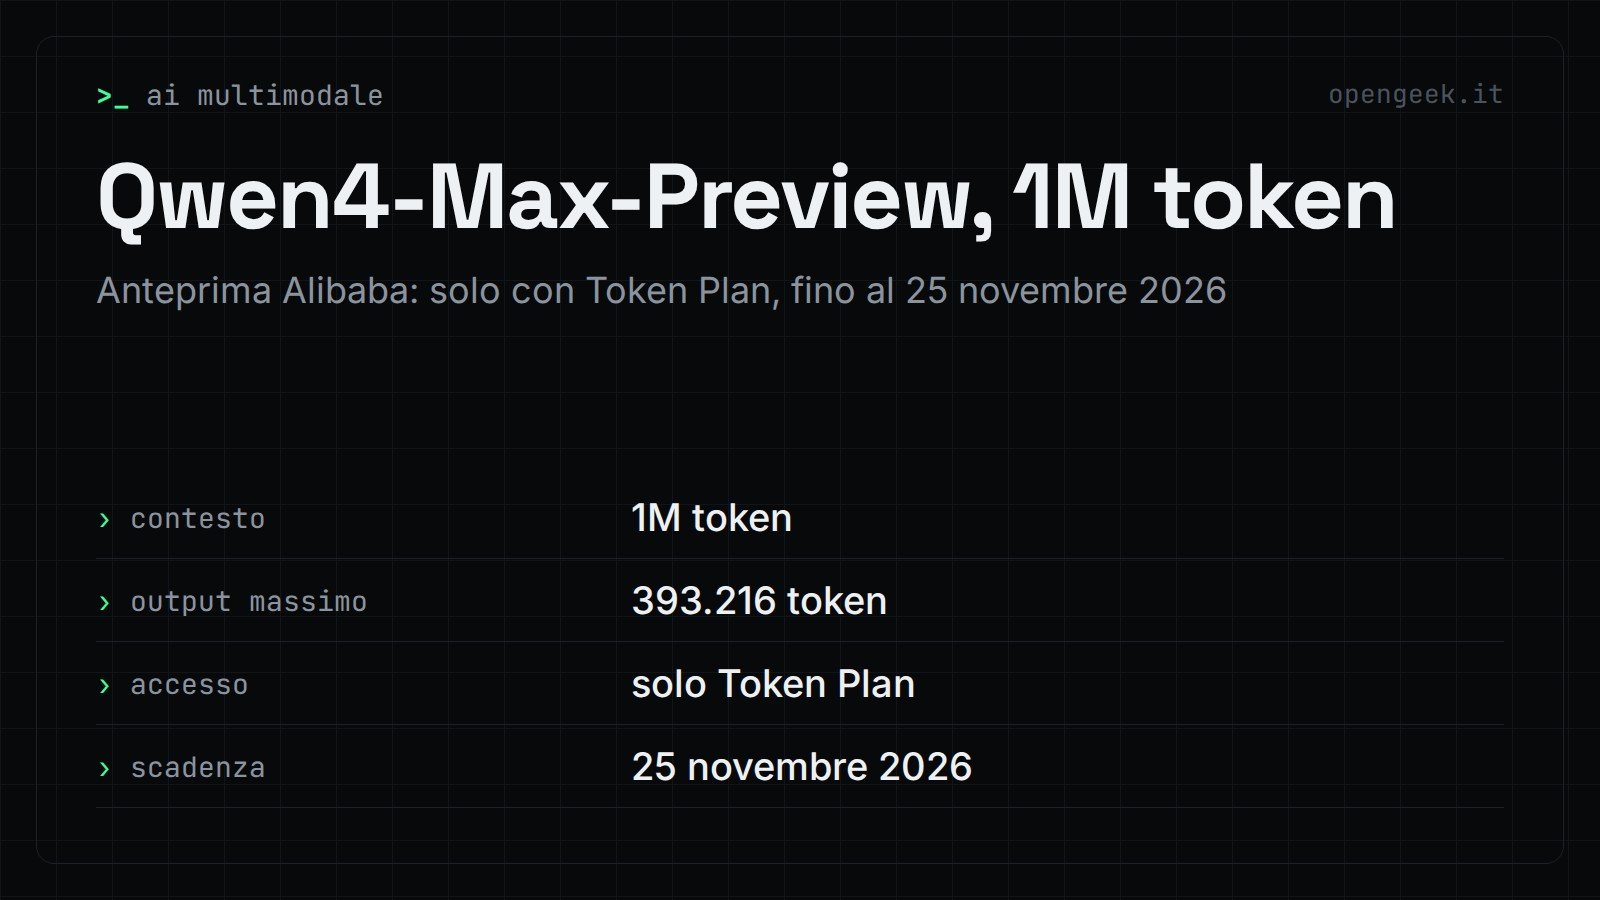
Per chi sviluppa conta la scadenza: l’anteprima si chiude alle 24:00 del 25 novembre 2026 (UTC+8). Poi il modello sarà ritirato e Alibaba indica come versione da usare Qwen4-Max, quella di produzione, già disponibile.
Cosa sa fare Qwen4-Max-Preview
Alibaba lo descrive come modello multimodale di nuova generazione, che unisce generazione di testo, comprensione di immagini e video e ragionamento approfondito. Gli ambiti indicati sono programmazione, produttività d’ufficio, frontend design e compiti agentici complessi, cioè quelli in cui il modello esegue più passaggi usando strumenti.
In ingresso accetta testo, immagini e video. Supporta il function calling (il modello richiama funzioni definite da chi sviluppa), la ricerca web e strumenti integrati, e può restituire output strutturati in JSON Object e JSON Schema.
Contesto, ragionamento e API: le specifiche
- Contesto di 1M token; output massimo di 393.216 token, condivisi fra ragionamento e risposta finale.
- Ragionamento attivo di default, regolabile con
reasoning_effort:low,mediumoxhigh, che è il valore predefinito. Non vanno impostati insiemereasoning_effortethinking_budget. - Compatibile con le API OpenAI Chat Completions, OpenAI Responses e Anthropic Messages.
- Nelle conversazioni multi-turno con Chat Completions
preserve_thinkingè attivo di default: il ragionamento dei turni precedenti va restituito nel camporeasoning_contentdei messaggi dell’assistente, senza accodarlo acontent.
Cosa controllare nel codice esistente: max_tokens
Chi ha già integrazioni con i modelli Qwen deve guardare la nota sul budget di output. Con qwen4-max-preview, in Chat Completions max_tokens equivale a max_completion_tokens, ed entrambi limitano insieme i token di ragionamento e quelli della risposta.
Il ragionamento consuma quindi parte dello stesso budget, e un limite dimensionato sulla sola risposta può troncare l’output. Alibaba indica di lasciare spazio a entrambi quando si sceglie il valore. I modelli Qwen esistenti mantengono il comportamento precedente.
Accesso e costi: solo Token Plan, senza prezzi nella pagina
Il modello è in anteprima e disponibile solo tramite Token Plan, per uso interattivo negli strumenti AI di coding e agenti compatibili. È vietato usarlo tramite script automatici o backend applicativi, pena possibile sospensione dell’abbonamento o revoca della chiave API. Alibaba precisa che durante l’anteprima le capacità del modello continuano a essere aggiornate. La pagina non riporta prezzi: rimanda alle guide di Token Plan per client supportati, configurazione e benefici in Credits. La pagina non specifica l’accessibilità dall’Italia. La guida di Token Plan Personal indica però Singapore come unica regione e Global come unico deployment: l’inferenza avviene globalmente e prompt e risposte comportano trasferimenti transfrontalieri, la cui conformità alle norme applicabili è responsabilità dell’utente.
Come provarlo
- Scegliere Token Plan Personal o Token Plan Team e seguire la guida per ottenere una chiave API dedicata.
- Usare il Base URL dedicato
https://token-plan.ap-southeast-1.maas.aliyuncs.com; gli endpoint completi per ciascun protocollo sono nella guida di Token Plan. - Impostare come model ID
qwen4-max-preview.