Computer
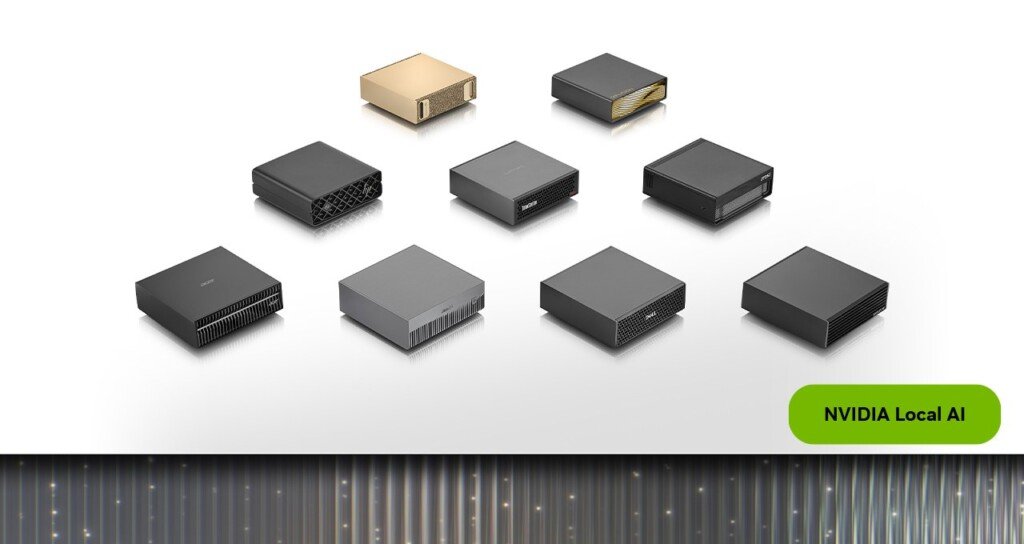
NVIDIA porta DGX Spark in una nuova configurazione da 64GB di memoria unificata, più accessibile della versione da 128GB. Secondo il comunicato di NVIDIA, del 2 ottobre 2026, il modello sarà disponibile il 23 ottobre a partire da 4.999 dollari presso Acer, ASUS, Dell, Gigabyte, HP e MSI. Prezzi e disponibilità per l’Italia non sono ancora stati comunicati.
Cosa cambia con la versione da 64GB
La nuova variante mantiene il superchip GB10 Grace Blackwell, DGX OS e lo stesso stack software NVIDIA del modello da 128GB. Cambia la quantità di memoria, e di conseguenza il prezzo d’ingresso. NVIDIA precisa che questa configurazione è venduta solo dai partner produttori.
Secondo NVIDIA, con 64GB si possono far girare in locale modelli fino a 100 miliardi di parametri e le applicazioni agentiche costruite su di essi, senza dipendere dal cloud. DGX Spark integra anche rete ConnectX-7 e software accelerato CUDA, ed è pensato per agenti, inferenza, fine-tuning, data science e sviluppo edge.
Due unità in cluster con NVIDIA Sync
Ogni DGX Spark ha una scheda di rete ConnectX-7 integrata. Secondo NVIDIA, due unità si collegano direttamente con un cavo QSFP e mettono in comune la memoria, arrivando a 128GB e a modelli fino a 200 miliardi di parametri.
La configurazione è affidata alla funzione Cluster Assistant dell’app NVIDIA Sync, che rileva le unità collegate, verifica la configurazione e imposta la rete ConnectX-7. Ogni nodo usa lo stesso stack software NVIDIA, ma Cluster Assistant configura solo la rete: i carichi distribuiti vanno impostati separatamente.
| Configurazione | Memoria | Modelli supportati |
|---|---|---|
| Una DGX Spark 64GB | 64GB | fino a 100 miliardi di parametri |
| Due DGX Spark 64GB in cluster | 128GB | fino a 200 miliardi di parametri |
Il cluster offre il doppio della banda di memoria e, secondo NVIDIA, fino a 1,7 volte le prestazioni. Il dato viene da un test interno con Qwen3.8 27B: due sistemi da 64GB in cluster contro un singolo sistema.
Software pronto e Model Launcher a fine ottobre
Il sistema arriva con NVIDIA Agent Toolkit, le librerie CUDA-X AI, i modelli aperti Nemotron e runtime come Ollama, vLLM e PyTorch con CUDA. NVIDIA parla di pochi minuti dall’accensione all’esecuzione dei modelli. Blender è tra i primi fornitori di applicazioni creative a supportare la piattaforma, con un installer scaricabile in arrivo.
A fine ottobre arriverà NVIDIA Sync Model Launcher, che permette di scaricare e avviare Qwen3.8 27B su un singolo sistema o su un cluster con pochi clic. Il modello resta accessibile dal proprio laptop e il launcher configura anche OpenCode, così da programmare dal browser.
Gli usi indicati da NVIDIA
- Agente sempre attivo: un agente di coding o di ricerca che rivede codice, analizza documenti o esegue compiti in più passaggi; il cluster dà spazio a modelli più grandi, contesti più lunghi o più agenti insieme.
- Supporto al PC di tutti i giorni: DGX Spark esegue l’inferenza di un modello linguistico o di generazione immagini, mentre laptop e desktop usano agenti o applicazioni creative.
- Crescita del carico: quando un compito supera una sola unità, due sistemi collegati sulla rete a 200 GbE mettono in comune la memoria fino a 128GB; Cluster Assistant configura la rete, mentre runtime e carichi distribuiti vanno impostati a parte.
Come iniziare
- Scaricare un framework di inferenza supportato: llama.cpp, Ollama, vLLM o LM Studio.
- Scaricare il modello locale consigliato per il proprio flusso di lavoro.
- Per passare a due unità, aggiornare i sistemi (software di aprile 2026 o successivo), aggiungerli a NVIDIA Sync con accesso SSH e privilegi sudo e collegarli tramite le porte ConnectX-7 con un cavo QSFP112 DAC 400 GbE compatibile in modalità Ethernet. Avviare NVIDIA Sync Cluster Assistant per configurare rete e SSH; i carichi distribuiti vanno poi configurati seguendo il playbook del runtime scelto.
I playbook per agenti su build.nvidia.com includono NemoClaw, OpenClaw, Hermes Agent e OpenShell. Per i dispositivi da 64GB saranno aggiunti presto quelli su vLLM, su OpenClaw con LLM locale e sul collegamento di più DGX Spark per carichi distribuiti.