NVIDIA Cosmos 3 Nano: quattro modelli aperti per guida autonoma e robot

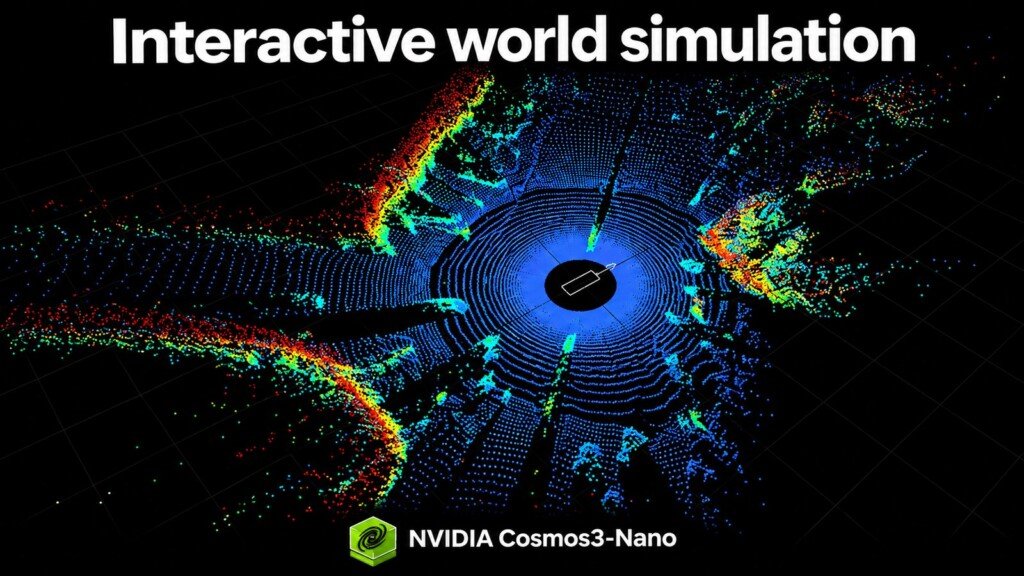
Un modello che riceve i controlli di una scena stradale e genera il video sincronizzato di fino a 11 telecamere, LiDAR compreso, con meteo e ora del giorno a scelta: è Cosmos3-Nano-Transfer-Auto, uno dei quattro nuovi checkpoint open-weight che NVIDIA ha aggiunto alla famiglia Cosmos 3. Li descrive il post pubblicato il 5 novembre 2026 sul blog di Hugging Face dal team NVIDIA. Per chi sviluppa guida autonoma o robotica, significa avere pesi e ricette di post-training da adattare ai propri dati, con licenza OpenMDW1.1.
Tutti e quattro sono esempi post-addestrati di Cosmos 3 Nano, con 16 miliardi di parametri addestrabili. Secondo il post, la licenza OpenMDW1.1 consente l’uso commerciale e non commerciale, alle condizioni dei suoi termini.
Cosa fanno i quattro modelli
- Cosmos3-Nano-Transfer-Auto: modello bidirezionale per generare offline dati di guida sintetici. Produce video sincronizzato fino a 11 telecamere, fisheye incluse, e supporta la generazione congiunta di RGB e LiDAR.
- Cosmos3-Nano-Sim-Auto: la variante in streaming di Transfer-Auto, distillata in modo causale. Genera blocchi successivi di video e LiDAR sincronizzati in pochi passi di denoising, per simulazioni lunghe e interattive.
- Cosmos3-Nano-Sim-Transfer: trasforma i controlli di un simulatore fisico e un testo in video fotorealistico.
- Cosmos3-Nano-Sim-Bimanual: prevede il video a partire dalle azioni di un robot o di una camera.
In Transfer-Auto, i controlli World Scenario Map (WSM), uno per telecamera, definiscono la struttura della scena e il traffico, mentre il testo guida l’aspetto. Si possono variare meteo, illuminazione e ora del giorno, con immagini RGB iniziali facoltative per ancorare l’aspetto della scena. Per il LiDAR servono in più controlli range-map ricavati da una mappa HD, allineati a quelli delle camere. I controlli su scena e semafori permettono inoltre di cambiare il layout stradale e lo stato dei semafori e di osservare come reagisce una policy di guida.
Sim-Transfer riceve dal simulatore profondità, segmentazione, bordi e sfocatura. Il testo guida solo l’aspetto, mentre fisica e stato reale restano al simulatore. Il ciclo è: azione, aggiornamento del simulatore, controlli spaziali, RGB generato, nuova azione della policy.
Sim-Bimanual non ha un simulatore fisico in mezzo: si parte da un’immagine, si muove robot o camera e il modello genera le osservazioni successive. Secondo il post supporta la simulazione a due bracci per i robot YAM e AgiBot, guidati da una policy o da joystick (la scheda del modello elenca però solo AgiBot), e una stessa sequenza di controlli può alternare cambi di punto di vista e manipolazione.
Come funziona lo streaming
Secondo NVIDIA, il backbone di Cosmos 3 è un Mixture-of-Transformers, che collega tramite attenzione reti separate per il testo e per la generazione visiva. Ogni segmento breve viene previsto dal prompt, dai controlli disponibili e dalla cronologia già generata. L’attenzione temporale-causale permette di leggere cronologia e controlli senza vedere le osservazioni future, e una cache key/value conserva le informazioni per la previsione successiva.
Il modello non lavora sui fotogrammi grezzi ma su latenti, rappresentazioni video compresse: dopo l’immagine iniziale, ogni passo latente corrisponde a quattro frame RGB. Transfer ne prevede uno per blocco, il setup Bimanual ottimizzato descritto nel report due. Blocchi più piccoli fanno sentire più spesso l’effetto dei nuovi controlli.
L’addestramento segue quattro stadi: adattamento bidirezionale, teacher forcing, consistency distillation (uno studente che genera ogni blocco in quattro passi di denoising) e self-forcing. L’ultimo serve perché un oggetto previsto in modo leggermente sbagliato diventa contesto per i frame successivi e gli errori si accumulano: il self-forcing addestra il modello sulla cronologia che ha generato lui stesso. Distillazione e cache riducono il costo di ogni osservazione.
Limiti e condizioni dichiarati
Sim-Auto richiede una didascalia per ogni telecamera e controlli WSM sincronizzati, con immagini RGB iniziali facoltative. L’interazione a ciclo chiuso richiede un runtime di simulazione e un renderer WSM che aggiornino i controlli a partire dagli input di guida. Per un nuovo rig di sensori si adatta prima Transfer-Auto, poi lo si distilla in Sim-Auto.
NVIDIA scrive che questi problemi restano difficili: il lavoro da fare è misurare dove i modelli sostengono fedelmente l’apprendimento e la valutazione delle policy, capirne i limiti e migliorare dove falliscono.
Requisiti e come adattarli ai propri dati
Per Sim-Bimanual i requisiti indicati sono Linux, una GPU NVIDIA, Docker e NVIDIA Container Toolkit. Il setup vLLM-Omni pubblicato è stato provato su una GB200, ma NVIDIA precisa che non è una specifica di memoria minima. Il server scarica i pesi, i client gli input di esempio.
Transfer-Auto è la base per adattare Cosmos al proprio rig: si fa post-training sui propri dati, per disposizione delle telecamere, configurazione LiDAR e ambiente. Il modello adattato si usa direttamente per dati offline, oppure passa da addestramento causale e distillazione a pochi passi per la simulazione in streaming, lo stesso percorso con cui è stato creato Sim-Auto.
Le ricette di post-training partono da Cosmos3-Nano o da pesi base compatibili e coprono tutti e quattro gli stadi, con una ricetta per ciascun modello. I checkpoint di training completi servono per riprendere l’addestramento, mentre i pesi di inferenza esportati non contengono ottimizzatore e stato di training.
Per ogni modello esistono una skill aperta per agenti, con cui eseguire l’inferenza, e un notebook. NVIDIA suggerisce di dare al coding agent la skill e il percorso del dataset, fare i controlli d’ambiente, validare un campione e provare addestramento e riavvio prima di un run lungo. La valutazione va fatta su episodi di test: un run breve riuscito, avverte NVIDIA, verifica l’esecuzione, non la convergenza.