Fish Audio Drama 3: TTS open-weight da 35B parametri e 83 lingue

Il 13 ottobre 2026 Fish Audio ha presentato Drama 3, un modello text-to-speech con 35 miliardi di parametri e architettura mixture-of-experts, di cui circa 3 miliardi attivi per token. Come racconta il blog ufficiale di Fish Audio, i pesi sono pubblicati su Hugging Face e il codice su GitHub. Il modello parla 83 lingue e si può usare gratis, anche a fini commerciali, finché i ricavi annui restano sotto i 500.000 dollari.
Cosa ha rilasciato Fish Audio
Drama 3 è disponibile nella sezione Text to Speech di fish.audio, nell’app Fish Audio per iOS e Android e tramite API. I pesi sono su Hugging Face (huggingface.co/fishaudio/drama-3), il codice su GitHub (github.com/fishaudio/fish-speech). Fish Audio precisa che si tratta di un modello open-weight e non open source.
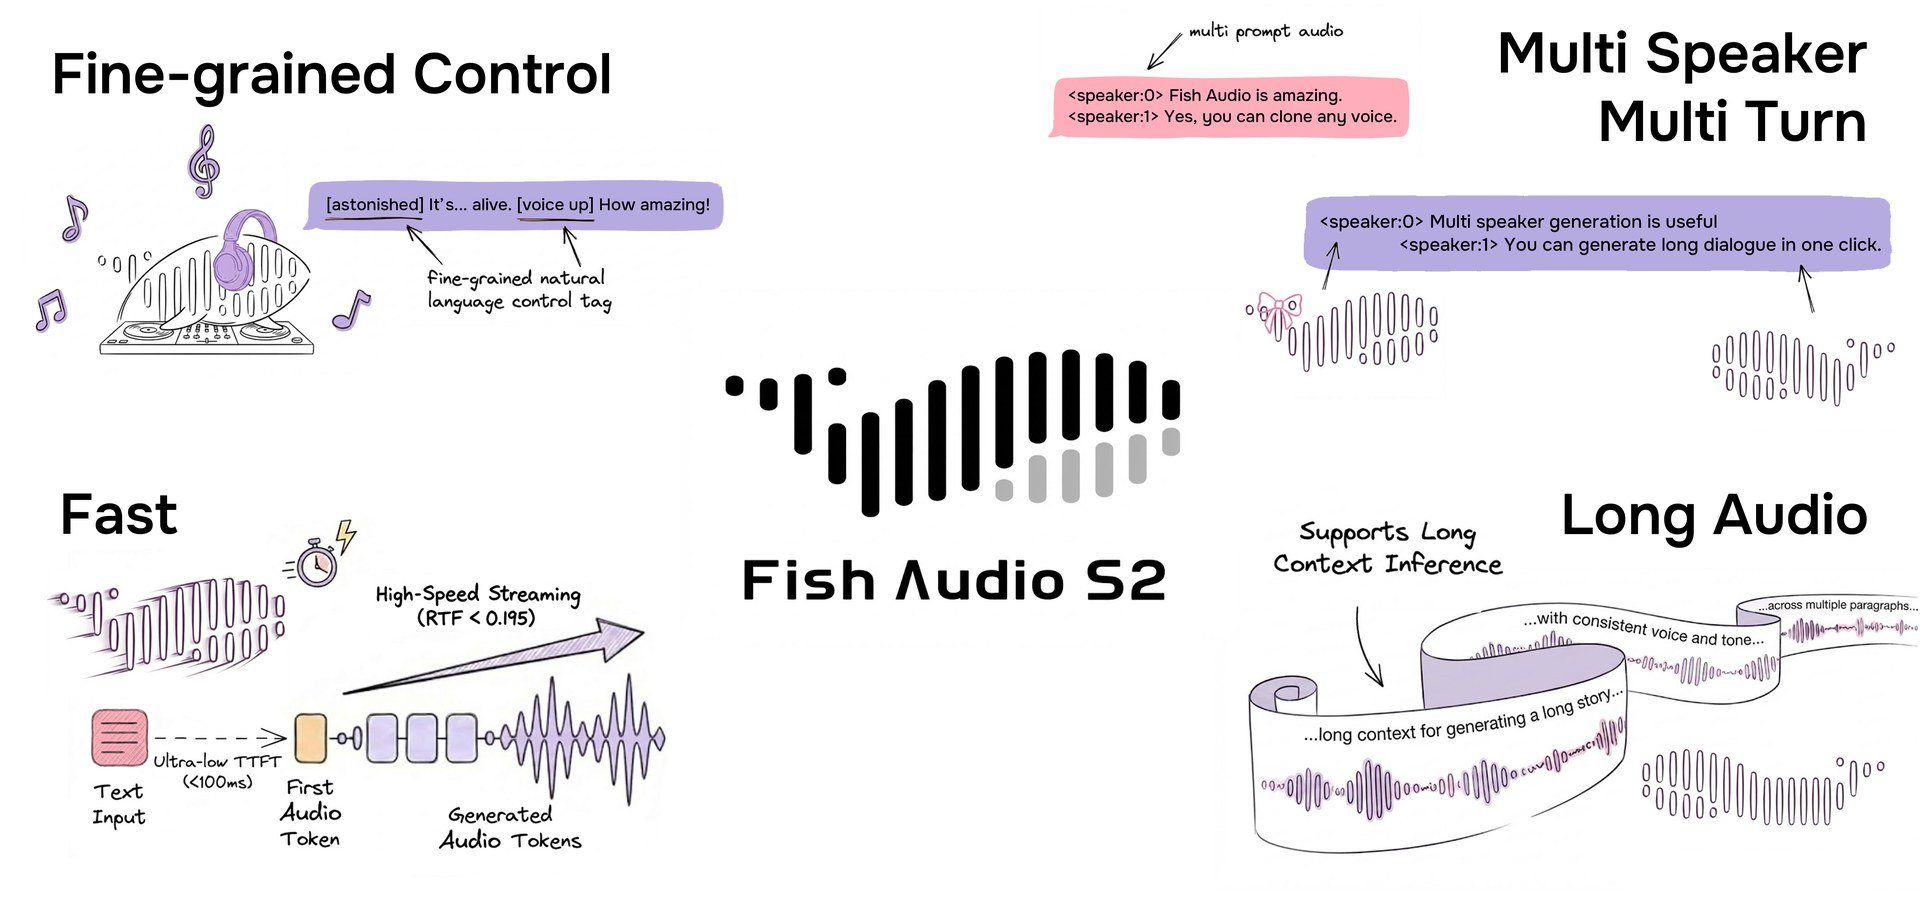
La voce si dirige con istruzioni scritte tra parentesi quadre, come [whispering] o [shaky breath]. Una nuova istruzione a metà battuta cambia la lettura da quel punto in poi. Per intervenire solo su alcune parole si usano tag accoppiati, per esempio <emphasis>…</emphasis> o <whisper>…</whisper>.
Le istruzioni possono essere scritte in una lingua diversa da quella della battuta. Secondo Fish Audio il modello è pensato per testi scritti da generare una volta e conservare, come audiolibri, audio drama, dialoghi di giochi e video brevi.
Com’è fatto: 35B MoE con circa 3B attivi
Il backbone è un mixture-of-experts da 35 miliardi di parametri: per ogni token ne lavorano circa 3 miliardi, cioè 8 esperti instradati su 256 più uno condiviso. È inizializzato a partire dal modello linguistico di Qwen3.5-35B-A3B. Fish Audio descrive così le scelte principali:
- Attenzione ibrida su 40 layer, a blocchi di tre layer Gated DeltaNet e uno di full attention con gate. Solo un layer su quattro mantiene una KV cache, gli altri tengono la storia in uno stato di dimensione costante.
- Un nuovo decoder audio, il codebook-MTP, al posto del Fast AR per frame di S2: quattro layer condivisi e nove layer a piena larghezza, uno per ciascun codebook acustico da 1 a 9.
- Nel backbone rientrano solo i codebook 0 e 1, mentre S2 li reimmetteva tutti e dieci, per limitare l’exposure bias. I codici da 2 a 9 vanno direttamente al decoder.
- Il tokenizer è quello di S2, invariato: si basa sul Descript Audio Codec, lavora a 44,1 kHz con dieci codebook (uno semantico, nove residui) e circa 21,5 frame al secondo, ed è completamente causale.
- Il training prevede tre fasi di pre-training, instruction fine-tuning e RL con un solo reward model di preferenza umana, senza reward basati su regole.
Velocità di inferenza
Secondo Fish Audio, su una GPU H200 il motore di inferenza decodifica un singolo stream a 271 frame al secondo, contro i 177 di S2, anche se Drama 3 ha più di sette volte i parametri. L’inferenza è disponibile tramite SGLang-Omni. Il dato è misurato su hardware da data center: la pagina non indica i requisiti per farlo girare in locale su una macchina consumer, né se esistano versioni quantizzate.
Licenza: cosa si può fare e cosa no
Drama 3 esce con la nuova Fish Audio Community License v1.0. È gratuita per ricerca e uso non commerciale, e per uso commerciale se l’utente e le sue affiliate hanno ricavi annui sotto i 500.000 dollari USA. Restano alcuni limiti, che qui si riassumono in modo non esaustivo:
- Sopra la soglia, o per offrire Drama 3 ad altri come servizio o API di TTS, clonazione vocale o inferenza, serve una licenza da Fish Audio ([email protected]).
- Sono ammesse demo di ricerca non commerciali gratuite e la produzione di audio finito per clienti.
- È vietato clonare la voce di una persona reale senza il suo consenso.
- S2, il modello precedente, resta sotto la Fish Audio Research License.
Pronuncia: il benchmark di Artificial Analysis
Fish Audio cita il benchmark Pronunciation Robustness di Artificial Analysis, che inserisce parole difficili in frasi inglesi: numeri, codici, marchi e parole la cui lettura dipende dal contesto. Ascoltatori umani controllano ogni parola. Secondo l’azienda, Drama 3 è al primo posto della classifica con il 93,2% di parole lette correttamente, contro l’88,1% di S2.1 Pro. Il dettaglio per categoria, secondo i dati riportati da Fish Audio:
| Categoria | Drama 3 | S2.1 Pro |
|---|---|---|
| Marchi, luoghi e termini tecnici | 95,9% | 87,3% |
| Parole dipendenti dal contesto | 95,3% | 86,1% |
| Abbreviazioni: numeri, date, unità, notazione | 93,6% | 92,7% |
| Sequenze esatte: codici, percorsi, email | 86,3% | 79,4% |
| Complessivo | 93,2% | 88,1% |
Il miglioramento nell’espressività rispetto a S2.1 Pro, cioè più emozione e maggiore aderenza alla direzione, è invece un’affermazione di Fish Audio, di cui la pagina non riporta una misura indipendente.
API e prezzi
Via API si usa lo stesso endpoint di S2.1 Pro, POST https://api.fish.audio/v1/tts, con l’header model: drama-3; i tag vanno nel campo text.
Il listino API è di 50 dollari per milione di caratteri. Dal 13 ottobre al 12 novembre 2026 c’è uno sconto dell’80%, che porta il prezzo a 10 dollari per milione di caratteri. Prezzi in euro e disponibilità specifiche per l’Italia non sono indicati. Per i creator, Drama 3 costa gli stessi crediti di S2.1 Pro.
Due strumenti in arrivo: editing interattivo e audio inpainting sono in test ristretto su invito; un’API di editing è annunciata senza data.