AI in locale
Liquid AI ha rilasciato LFM2.5-24B-A2B, un modello di ragionamento da 24 miliardi di parametri totali, di cui solo 2 miliardi attivi per token, che l’azienda presenta come pensato per agenti veloci e privati sul dispositivo. Secondo la pagina ufficiale di Liquid AI, sia la versione base (LFM2.5-24B-A2B-Base) sia quella post-addestrata sono open-weight e disponibili su Hugging Face e sul Playground dell’azienda.
Cosa cambia rispetto a LFM2-24B-A2B
Liquid AI presenta LFM2.5-24B-A2B come il più grande e l’ultimo modello della famiglia LFM2.5, che va da LFM2.5-230M fino a questo da 24B. Rispetto al predecessore LFM2-24B-A2B le novità sono queste:
- contesto esteso da 32.768 a 131.072 token;
- vocabolario raddoppiato da 65K a 128K token, per tokenizzare meglio i testi non latini;
- pre-training portato da 17T a 33T token;
- reinforcement learning agentico eseguito dentro harness come OpenClaw, Hermes Agent, Pi e OpenCode;
- modello solo ragionamento: produce una catena di pensiero esplicita prima della risposta finale, scelta che l’azienda motiva con l’alta velocità di decodifica e con la qualità delle risposte.
Secondo l’azienda l’architettura resta la stessa: 40 layer, 64 esperti per blocco MoE con routing top-4 e un ibrido di convoluzioni brevi con gate e GQA.
Benchmark dichiarati da Liquid AI: bene su agenti e istruzioni, meno su conoscenza e coding
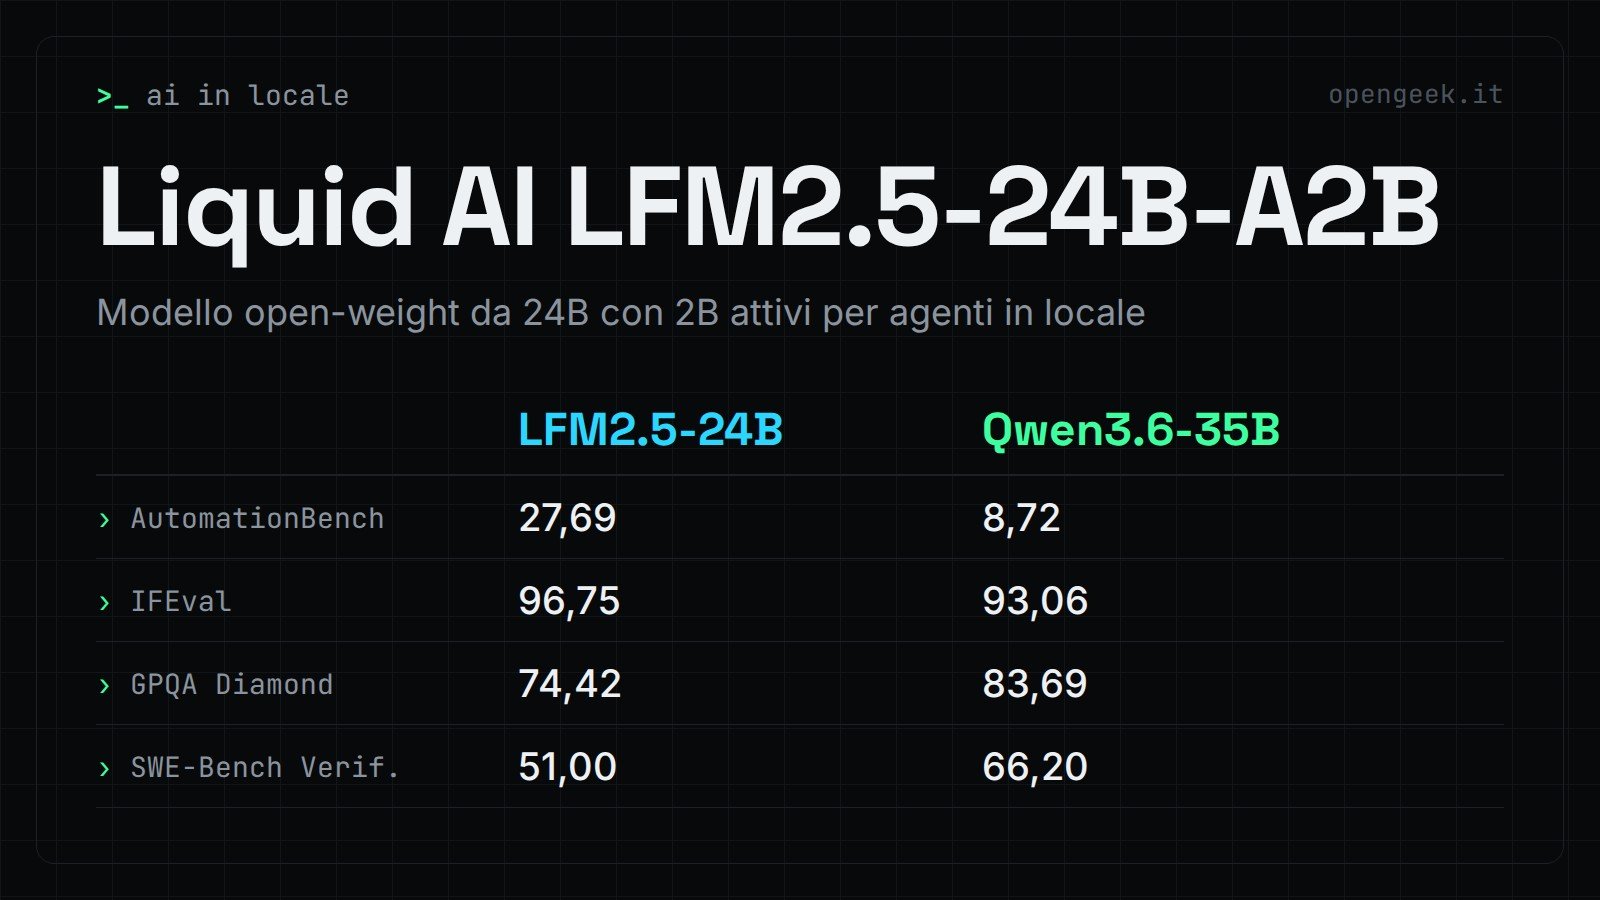
I numeri sono misurati da Liquid AI e la pagina non riporta verifiche indipendenti. Il confronto principale è con Qwen3.6-35B-A3B, che ha circa il 50% di parametri in più, totali e attivi. Per l’azienda il suo modello regge il confronto su cinque degli otto benchmark agentici e di tool use e guida tutti e tre quelli di instruction following. Tutti i modelli sono stati valutati con vLLM, in ambienti di valutazione sigillati, resi più rigidi dopo comportamenti di reward hacking del modello in addestramento.
| Benchmark | LFM2.5-24B-A2B | Qwen3.6-35B-A3B |
|---|---|---|
| AutomationBench | 27,69 | 8,72 |
| LiveClaw | 48,09 | 38,19 |
| ToolSandbox | 80,71 | 75,02 |
| BFCLv4 | 65,01 | 65,00 |
| τ³-Bench Banking | 8,04 | 7,63 |
| IFBench | 74,69 | 64,21 |
| IFEval | 96,75 | 93,06 |
| Multi-IF | 84,38 | 81,53 |
| GPQA Diamond | 74,42 | 83,69 |
| SWE-Bench Verified (OpenCode) | 51,00 | 66,20 |
| SciCode | 32,71 | 37,35 |
| PinchBench | 83,18 | 89,93 |
| WebArena Verified | 26,75 | 37,62 |
Secondo Liquid AI, su AutomationBench il modello totalizza più del triplo del secondo classificato. I modelli più grandi, riconosce Liquid AI, restano avanti sui test ad alta intensità di conoscenza come GPQA Diamond, HLE e AA-Omniscience e su quelli di coding come SWE-Bench Verified e SciCode. Per i carichi di lavoro che richiedono molta conoscenza l’azienda consiglia di abbinare il modello a retrieval o ricerca web.
Velocità e hardware supportato
Secondo Liquid AI il supporto c’è dal primo giorno per llama.cpp (con checkpoint GGUF), MLX per Apple Silicon, vLLM, SGLang e ONNX. L’azienda dichiara 184 token al secondo in decodifica su un Apple M5 Max e 114 su un AMD Ryzen AI Max+ 395, fino a 1,7 volte più veloce del modello successivo tra i MoE confrontati e con il minor uso di memoria.
Secondo Liquid AI, su una singola NVIDIA B300, con carico sostenuto ad alta concorrenza, il modello supera i 21.000 token in uscita al secondo. Il test usa SGLang 0.5.22, precisione BF16, 1.024 token in ingresso e fino a 256 in uscita. Le misure sono state raccolte su Pipette, l’infrastruttura di benchmark di Liquid AI.
La demo: Hermes Agent su un MacBook Pro
Nel video dimostrativo il modello gira dentro Hermes Agent su un MacBook Pro con M5 Max. Prepara un riepilogo dei modelli di tendenza su Hugging Face e risponde alle domande successive, pianificando e chiamando strumenti senza API cloud. Per Liquid AI il ciclo di invocazione degli strumenti risulta interattivo su hardware consumer, con tempi ben sotto il secondo per passaggio, tracce complete delle operazioni e dati che non lasciano il dispositivo.
Dove scaricarlo e prezzi dell’API
I pesi si scaricano da Hugging Face con licenza LFM Open License v1.0. Per le aziende con ricavi annui pari o superiori a 10 milioni di dollari, l’uso commerciale non è coperto dalla licenza e richiede una licenza commerciale da acquistare presso Liquid AI; ricerca e uso non profit qualificato restano consentiti senza soglie. La documentazione di Liquid AI spiega come eseguire il modello e farne il fine-tuning in locale, e una guida dedicata mostra come servirlo e collegarlo all’harness agentico preferito.
In alternativa c’è l’API tramite Liquid Console, con 2 dollari di credito iniziale. I prezzi, in dollari, sono 0,10 per milione di token in input (0,05 per quelli in cache) e 1,00 per milione di token in output.
Dove si colloca rispetto ai modelli di decisione di Liquid AI
LFM2.5-24B-A2B è un LLM generativo per agenti che ragionano e chiamano strumenti, categoria diversa dai modelli di decisione d1-3B e d1-omni-600M, di cui avevamo parlato il 7 ottobre in questo articolo.