AI in locale
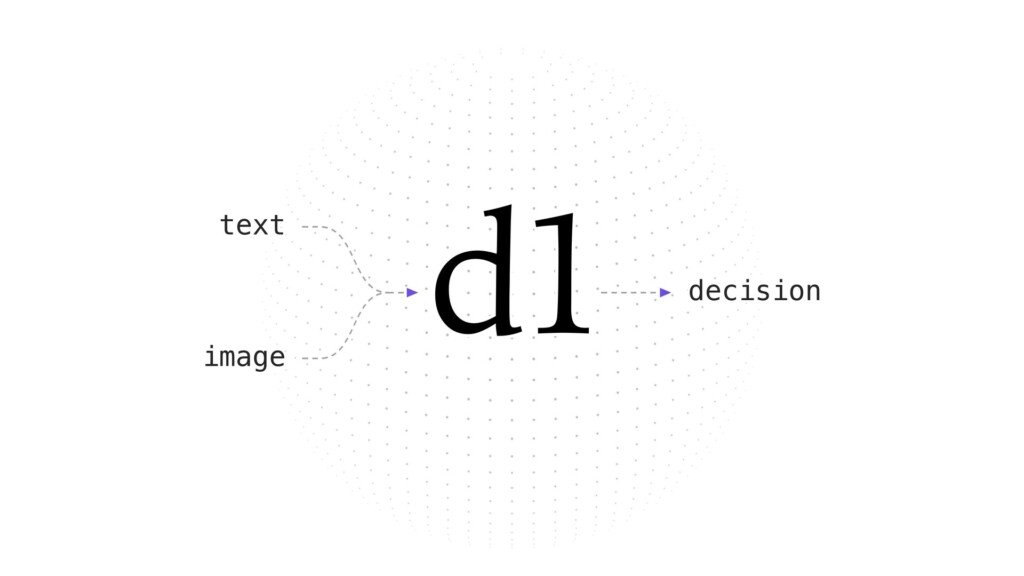
Il 7 ottobre Liquid AI ha rilasciato due modelli open-weight della sua famiglia d1 di «decision model»: d1-3B e d1-omni-600M, quest’ultimo ancora sperimentale. Come racconta il post di Liquid AI sul blog di Hugging Face, d1-3B ottiene 48,57 sul Decision Index 0.2.1 e risponde a una domanda in 16 ms su una NVIDIA Jetson AGX Thor. I pesi sono scaricabili da Hugging Face con la LFM Open License v1.0 di Liquid AI, Inc. (nella scheda dei modelli indicata come «other», nome lfm1.0). L’uso commerciale è soggetto a una soglia di fatturato annuo di 10 milioni di dollari: l’uso commerciale da parte di entità che la superano non è autorizzato da questa licenza.
Che cosa distingue un modello di decisione da uno generativo
I modelli d1 poggiano sui Liquid Foundation Models (LFM) dell’azienda. A differenza dei modelli generativi, non producono token uno dopo l’altro: danno la risposta in un solo passaggio in avanti (forward pass). Liquid AI li indica per decisioni rapide e strutturate, anche con input multimodali.
I due modelli partono da basi molto diverse:
- d1-3B deriva da LFM2.5-VL-3B, l’ultimo modello visione-linguaggio dell’azienda, di tipo decoder-only. Accetta testo e immagini.
- d1-omni-600M deriva da LFM2.5-Encoder-350M, un encoder bidirezionale a cui sono stati aggiunti encoder per visione e audio. Accetta testo e immagine oppure testo e audio. È una release di ricerca in fase iniziale, ancora in sviluppo.
Secondo la model card di d1-omni-600M, la parte audio è stata addestrata su richieste tra un parlante inglese e un assistente, con clip tagliate a 30 secondi. Il modello non è pensato per la chat e non scrive testo.
I risultati: per Liquid AI d1-3B è il migliore sotto i 10 miliardi di parametri
Secondo Liquid AI, d1-3B è il miglior modello di decisione sotto i 10B sul Decision Index 0.2.1: 48,57 punti, davanti a ogni modello da 4B e 9B e a Decider 35B-A3B, che ottiene 47,11. L’azienda ha poi misurato i due modelli su sette dataset pubblici, che coprono comprensione del testo, rilevamento di tossicità, classificazione di intenti, domande mediche e comprensione tra lingue diverse.
| Benchmark | d1-omni-600M | d1-3B | Decider 2B | Decider 4B |
|---|---|---|---|---|
| SQuAD 2.0 | 74,0 | 83,3 | 67,7 | 76,0 |
| Civil Comments | 95,8 | 93,3 | 93,6 | 92,8 |
| MASSIVE intent | 86,1 | 86,9 | 81,1 | 88,3 |
| PubMedQA | 61,3 | 68,3 | 65,7 | 63,3 |
| BoolQ | 77,7 | 86,3 | 87,3 | 89,0 |
| XNLI | 74,7 | 85,6 | 85,0 | 88,6 |
| PAWS-X | 79,5 | 76,4 | 59,5 | 69,8 |
| Media | 78,4 | 82,9 | 77,1 | 81,1 |
La media di d1-3B è 82,9, la più alta della tabella e sopra quella di Decider 4B (81,1). d1-omni-600M arriva a 78,4 e supera Decider 2B (77,1). Su BoolQ, XNLI e MASSIVE intent, però, Decider 4B resta avanti a d1-3B; su BoolQ lo supera anche Decider 2B.
Liquid AI precisa di non riportare benchmark su visione e audio: il Decision Index v0.3 include solo uno split visivo privato e i benchmark di decisione per l’audio sono, scrive, un problema ancora aperto. L’azienda dice di aver verificato che d1-3B mantiene le capacità visive di LFM2.5-VL-3B su benchmark standard e che d1-omni-600M gestisce tutte e tre le modalità.
Tempi di risposta su Jetson, Apple M5 Pro e GPU
La velocità di d1-3B è stata misurata in collaborazione con NVIDIA, sullo stack dell’azienda: GeForce RTX 4090, Jetson AGX Thor, Jetson AGX Orin 64 GB e Jetson Orin Nano. Per d1-omni-600M Liquid AI non fornisce dati di velocità, perché si tratta di una release di ricerca iniziale.
Con una singola domanda Liquid AI misura da 16 a 50 ms sui dispositivi edge; con uno stato di 3,4K token le latenze salgono fino a 1.640 ms. Tre domande costano circa 1,3 volte il tempo di una: su AGX Thor si passa da 16 a 20 ms.
| Dispositivo | Una domanda | Tre domande | Immagine da 384 px |
|---|---|---|---|
| Apple M5 Pro | 30 ms | 41 ms | 62 ms |
| Jetson AGX Thor | 16 ms | 20 ms | 35 ms |
| Jetson AGX Orin 64 GB | 26 ms | 35 ms | 83 ms |
| Jetson Orin Nano | 50 ms | 73 ms | 202 ms |
| NVIDIA RTX 4090 | 8 ms | 21 ms | 17 ms |
| AMD MI325X | 9 ms | 14 ms | 18 ms |
Su GPU, secondo la model card di d1-3B, le misure sono in bf16 (mediana di 20 esecuzioni). Il valore di 8 ms su RTX 4090 usa model.compile(mode="reduce-overhead"); senza, la singola domanda richiede 16 ms. Nella modalità con 64 stati raggruppati (packed) la tabella riporta 475 al secondo su RTX 4090 e 1.106 al secondo su AMD MI325X; sui dispositivi edge si va da 38 al secondo su Orin Nano a 262 su AGX Thor.
Come provarli
Per d1-3B servono transformers 5.14 o successivo, torch, torchvision e pillow:
pip install "transformers>=5.14" torch torchvision pillow
Per d1-omni-600M la model card indica transformers 5.15 o successivo, più soundfile:
pip install "transformers>=5.15" torch torchvision pillow soundfile
- I modelli includono codice proprio, quindi il caricamento richiede
trust_remote_code=True. - Nell’esempio di Liquid AI il modello si carica con
AutoModel.from_pretrained("LiquidAI/d1-3B"), in bfloat16 su GPU o in float32 su CPU. - Il metodo
system_oneaccetta più domande con nome su uno stesso stato, ad esempio di tipo «choice» con criteri o di tipo «score», e risponde in un solo passaggio. Un’immagine può costituire l’intero stato. - Il metodo
system_one_batchelabora più richieste insieme, senza padding.
L’esempio completo è per d1-3B; le istruzioni per d1-omni-600M sono nella sua model card. Chi vuole vedere d1-3B all’opera trova dieci demo con fotocamera, disegno e testo nello Space System One Arcade su Hugging Face.