Reflection Beam su Hugging Face: modello aperto da 501B con licenza Apache 2.0

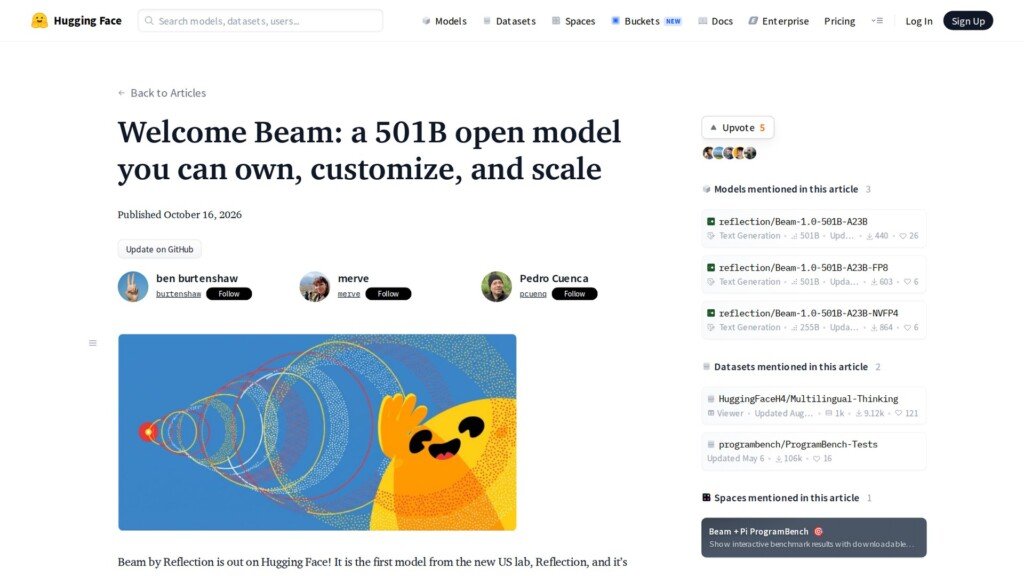
Il 16 ottobre 2026 Reflection, nuovo laboratorio statunitense, ha pubblicato su Hugging Face il suo primo modello, Beam. Come racconta il blog di Hugging Face, è un mixture-of-experts da 501 miliardi di parametri totali, 23 miliardi attivi per token, che accetta solo testo, gestisce un contesto da 1 milione di token ed è rilasciato con licenza Apache 2.0.
Cos’è Beam e cosa promette
Secondo Hugging Face, Beam è pensato per team che vogliono un modello di questa taglia sul proprio hardware, sulla propria infrastruttura o nel proprio cloud, e personalizzarlo. Il focus è su coding e uso agentico. Il modello arriva con un harness open source dedicato, scritto in Rust, che secondo il post ne ottiene le prestazioni migliori.
- 52 layer, 256 esperti per ogni layer MoE, 8 instradati per token.
- Checkpoint in BF16, FP8 e NVFP4; il BF16 pesa circa 1 TB in formato safetensors.
- Cinque livelli di reasoning: low, medium (predefinito), high, xhigh e max.
- Ragionamento che può restare nel contesto tra un turno e l’altro (
preserve_thinking) e tool calling con una grammatica dedicata. - Un modello draft per la decodifica speculativa, chiamato DFlash2.
Come spiega il post, tutti i 256 esperti restano in memoria: serve la memoria di un modello da 501B, ma la velocità di calcolo è quella di uno da 23B.
Contesto da 1M di token: come regge la memoria
L’attenzione è ibrida: 43 layer usano una finestra scorrevole di 512 token, 9 layer guardano l’intero contesto. Solo questi ultimi fanno crescere la cache KV, che sale di 36 KiB per token, circa un sesto dei 208 KiB che servirebbero se tutti i 52 layer fossero globali.
| Contesto | Se tutti i layer fossero globali | Beam |
|---|---|---|
| 32K token | 6,5 GiB | 1,2 GiB |
| 128K token | 26 GiB | 4,6 GiB |
| 1M token | 208 GiB | 36,08 GiB |
I valori sono per singola sequenza, in BF16, con la cache dinamica di transformers.
Quanto hardware serve
Hugging Face indica il checkpoint NVFP4 come il modo più pratico per servire Beam: porta i pesi da circa 1 TB a circa 280 GB e conserva gran parte della qualità del BF16. Gira nativamente sulle GPU Blackwell, non su quelle precedenti come le H200, per le quali c’è il checkpoint FP8.
- Due B200 (360 GB in totale) bastano per i pesi ma lasciano poco spazio per attivazioni e cache KV; il post consiglia quattro B200 (720 GB).
- In alternativa un nodo 8xB200, due B300 da 288 GB ciascuna, oppure 8xRTX Pro 6000.
- Con SGLang il checkpoint NVFP4 sta su 4 B300, quello FP8 su 8 H200.
- Con vLLM il BF16 si serve con tensor parallelism su 16 GPU, cioè due nodi 8x H200.
- Con transformers su 16 H200 ogni GPU tiene 78 GB di pesi; con 8 GPU ne servirebbero 139 su 141 disponibili, senza margine.
Con la decodifica speculativa DFlash2, in vLLM il drafter propone fino a 15 token in anticipo e Beam li verifica in un solo passaggio, al costo di un po’ di memoria in più.
Come provarlo: librerie e provider
Beam ha supporto day-0 in transformers (versione 5.20.1 o successiva), vLLM e SGLang. Per chi non ha GPU Blackwell o cluster, Hugging Face lo offre tramite Inference Providers, con Baseten, Fireworks e Together e altri in arrivo, e tramite Inference Endpoints, dove si può fare il deploy con un clic dal catalogo in FP8 o NVFP4, o dalla riga di comando con hf endpoints catalog deploy --repo reflection/Beam-1.0-501B-A23B --name beam.
I benchmark dichiarati da Reflection
Risultati forniti dal team Reflection e riportati da Hugging Face; non sono verifiche indipendenti.
| Benchmark | BF16 | FP8 | NVFP4 |
|---|---|---|---|
| SWE Bench Verified | 81,6% | 80,2% | 80,7% |
| Terminal Bench v2.1 | 80,1% | 78,9% | 78,2% |
| GPQA Diamond | 90,6% | 90,3% | 89,3% |
| AIME 2026 | 97,7% | 98,0% | 97,5% |
| LiveCodeBench | 88,3% | 88,1% | 87,4% |
Su HLE senza strumenti il checkpoint FP8 resta al 36,0% del BF16, l’NVFP4 scende al 34,8%. Hugging Face ha anche fatto prove qualitative su cinque compiti, a basso e alto reasoning, precisando che sono «vibe eval» e non benchmark; input, output e tracce sono in un bucket pubblico.
Personalizzarlo: fine-tuning e reinforcement learning
Per il fine-tuning supervisionato Hugging Face propone TRL con adattatori LoRA, invece di aggiornare tutti i 501B parametri. L’addestramento LoRA sta su un singolo nodo con 8 GPU B300, con circa 19.000 token al secondo; con le H100 servono quattro nodi.
Dopo un’epoca su Multilingual-Thinking, Beam ha ragionato nella lingua richiesta in 16 prompt su 16 tenuti da parte, contro 3 su 16 del modello base. Il post precisa che il test misura l’aderenza alla lingua, non la correttezza del ragionamento.
Per il reinforcement learning, Reflection e RadixArk hanno preparato una ricetta GRPO con Miles, in BF16, che può aggiornare tutto il modello o solo adattatori LoRA.
- GRPO full-parameter: 96 H200, di cui 64 per il training e 32 per i rollout, oppure 64 H200 in configurazione colocata.
- GRPO con LoRA: 32 H200, 16 per il training e 16 per i rollout.
Il concorso da 10.000 dollari
Reflection assegnerà 10.000 dollari in crediti Hub ai migliori progetti costruiti con Beam: una demo su Spaces, una versione quantizzata per un hardware specifico, un dataset sintetico, un ambiente di RL o un benchmark. Basta pubblicare il lavoro sull’Hub e condividerlo dalla pagina del modello.