Software e app
Anthropic ha costruito Scion, un sistema di controllo di versione interno, e ha migrato completamente il proprio monorepo da git in cinque mesi. Lo racconta il blog di ingegneria dell’azienda in un post del 13 ottobre 2026. A maggio 2026 Anthropic univa in media circa 2.500 modifiche al giorno; a settembre ne univa oltre 30.000.
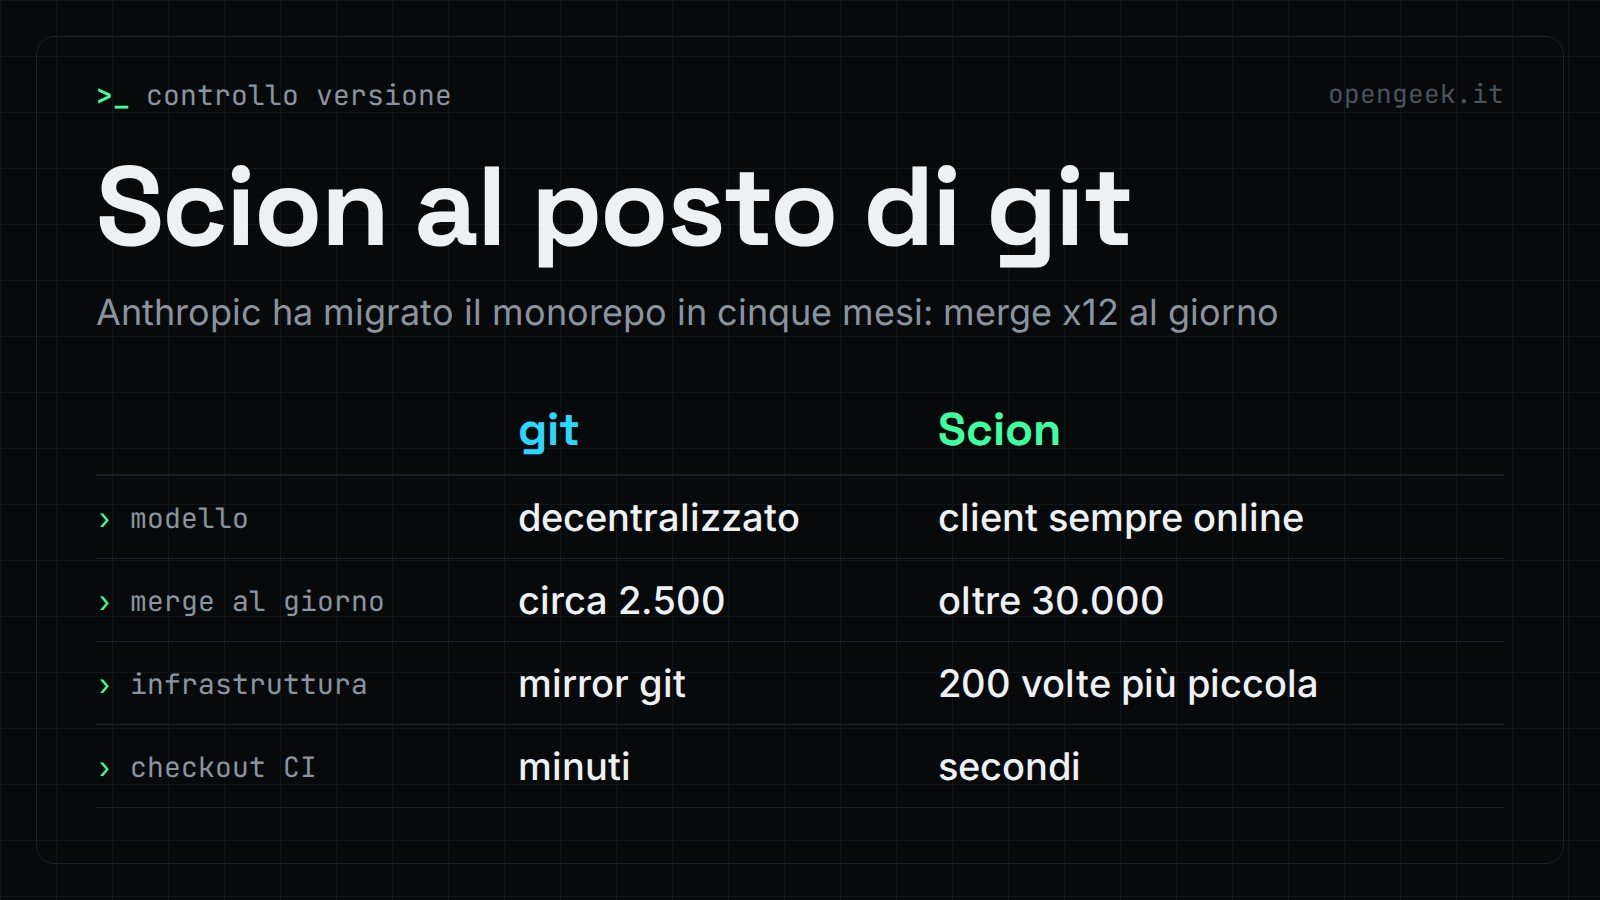
Il problema, spiega l’azienda, è che git è decentralizzato e pensato anche per il lavoro offline. Anthropic lo usava invece come sistema centralizzato, con quasi tutti i client agenti e job sempre online.
Perché git non bastava più per il monorepo di Anthropic
Secondo Anthropic scrivere codice non è più il collo di bottiglia: lo sono l’infrastruttura pensata per la scala umana, cioè controllo di versione, build e CI. L’azienda precisa che il proprio carico di lavoro è insolito e che altre organizzazioni potrebbero incontrare gli stessi limiti.
I numeri del post:
- la storia del solo ramo main pesa quasi 100 GB;
- la copia di lavoro compressa supera i 25 GB;
- per la CI si fanno circa 25 milioni di checkout al giorno, senza contare ambienti degli sviluppatori, sandbox degli agenti e job di ricerca;
- scaricati senza ottimizzazioni, quei checkout sarebbero oltre 600 PB di traffico git al giorno.
Anthropic ha provato gli strumenti di git per lavorare su una parte del repository (shallow clone, sparse checkout, promisor remote) e le soluzioni classiche per i monorepo: mirror interni e seed in blob storage. Al picco gestiva diverse centinaia di mirror git interni. Con l’aumento del ritmo di merge diventavano sempre più difficili da gestire, i seed si allontanavano dalla punta di main e le operazioni basate sulla storia, come diff e blame, richiedevano sempre più cure sui cloni parziali.
Come funziona Scion: i principi di progetto
Secondo Anthropic, Scion nasce dalla domanda su come sarebbe un controllo di versione progettato per agenti sempre online. Le scelte descritte nel post:
- Client sempre online. Il server risponde su storia e blame, crea commit, esegue merge e rebase. Il client tiene una cache locale limitata di oggetti, dispone i file su disco e osserva le modifiche al filesystem.
- Query anche via API. Tutte le query usate dal client sono esposte anche come API, quindi in molti casi i job non hanno bisogno di un repository locale. Le pipeline interne di bisect e revert automatici si appoggiano a questo accesso.
- Scalabilità orizzontale. I dati sono distribuiti e ogni componente scala in modo indipendente. Non esiste una copia completa del repository nemmeno sul server e, senza packfile, non serve manutenzione.
- Commit economici e senza lock. Commit, rebase e merge avvengono sul server, quindi non c’è nulla da pushare. Il costo di un commit dipende dalla dimensione della modifica, non da quella del repo. I ref sono scoraggiati, tranne main e i rami di release.
- Working copy opzionale e sparsa. Il protocollo ruota attorno a checkout sparsi e virtualizzati, con file materializzati a richiesta. Molte scritture e query, come il diff rispetto al merge base, si fanno via API senza alcun checkout.
Changeset e dati derivati al posto dei commit
L’unità di lavoro di Scion è il «changeset», una voce di un write-ahead log creata lato server. Al posto del puntatore all’albero che hanno i commit git, contiene l’elenco dei file cambiati rispetto al primo genitore, con puntatori content-addressed ai contenuti compressi in blob storage.
Per rispondere a domande come chi ha modificato per ultimo una riga, Scion costruisce a parte altre strutture: blame, storia dei percorsi, skip list del grafo dei commit. Anthropic le chiama «dati derivati» e le calcola con un unico meccanismo ricorsivo, a partire dai genitori di ogni changeset. Si possono calcolare subito o rimandare e ottimizzare senza toccare il client.
Server, daemon e cache: l’architettura del checkout
Secondo l’azienda, i dati sono content-addressed e non cambiano una volta salvati, quindi qualsiasi server può metterli in cache senza coordinarsi con gli altri. I server sono in sostanza grandi cache che possono anche calcolare dati derivati e scriverli su Spanner.
Il client, chiamato scn, non dice al server che cosa ha già. Parte da un albero radice, chiede in modo ricorsivo gli alberi mancanti e poi i blob. Ogni richiesta riguarda un oggetto immutabile ed è riprendibile, senza un unico packfile da più gigabyte.
Il client parla con scion-daemon, che conserva gli oggetti per l’intero nodo. Il daemon interroga le cache regionali scion-cache; se manca un oggetto, queste si rivolgono agli scion-server, che leggono da Spanner o da cloud storage. I tre livelli rispondono alle stesse RPC, ma la gerarchia è imposta per isolare i guasti. Anthropic dichiara che ogni livello trova in cache oltre il 99% degli oggetti richiesti e non richiede stato di lunga durata.
I risultati dichiarati da Anthropic
| Voce | Dato dichiarato |
|---|---|
| Merge al giorno, maggio 2026 | circa 2.500 |
| Merge al giorno, settembre 2026 | oltre 30.000 |
| Infrastruttura Scion rispetto ai mirror git (CPU e memoria) | 200 volte più piccola |
| Checkout per CI e job di ricerca | due ordini di grandezza più rapidi (secondi invece di minuti) |
| Capacità CPU della sola CI | +25% |
Secondo Anthropic, Scion e lo strumento di code review Antique sono stati realizzati da un team di sette persone, mentre i merge giornalieri aumentavano di dieci volte.
Permessi, revisioni e merge senza coda
Scion supporta il controllo degli accessi sui repository e permessi sulle singole directory, per proteggere il codice sensibile senza rinunciare al monorepo. Secondo l’azienda, il team rivede ogni change request del sistema, ma ora esamina l’intento della modifica invece di leggere ogni riga. Gli ingegneri, scrive Anthropic, devono spesso dire «no» a Claude, che a volte viola vincoli fondamentali del sistema.
Anthropic spiega di non essere riuscita a replicare a questa scala il lock globale della merge queue, standard del settore, e ha puntato su test automatici post-merge e pre-deploy. Le modifiche concorrenti possono andare in conflitto, ma secondo l’azienda Claude di solito li risolve più in fretta di quanto gli umani riescano a individuarli.